



Xilinx представляет Alveo U55C: двойной HBM, масштабируемая кластеризация для HPC и Big-Data рабочих нагрузок
На суперкомпьютерной конференции SC21 Xilinx раскрыла ускоритель дата-центра Alveo U55C и новый, стандарты-базированный API-драйвенный кластеризационный решение, позволяющее клиентам развертывать FPGA в беспрецедентном масштабе. Позволяя кластеры сотен Alveo карт и упрощая приложение и кластер программирование, новая платформа делает масштабирование HPC рабочих нагрузок как легче, так и более эффективным.
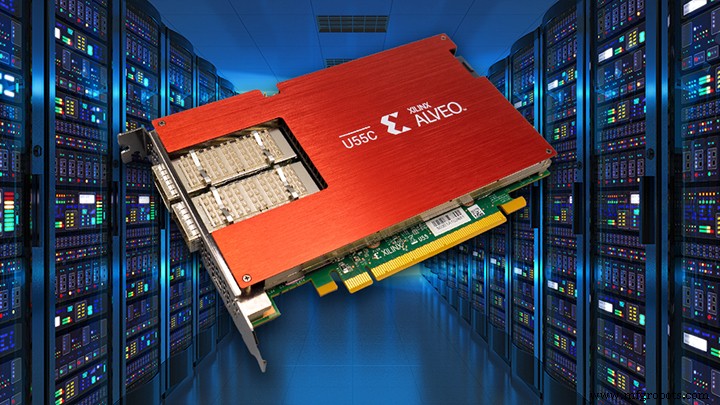
U55C спроектирован специально для высокопроизводительных вычислений и крупномасштабной аналитики данных. Он доставляет высокую вычислительную плотность и HBM емкость в линейке Alveo Xilinx. В паре с RoCE v2-базированным кластеризационным фреймворком, карта уполномачивает пользователей строить мощные FPGA-базированные HPC кластеры используя их существующие дата-центр серверы и Ethernet сети.
«Это крупный шаг к более широкому принятию Alveo и адаптивных вычислений в дата-центре», — сказал Xilinx.
В интервью с embedded.com, Натан Чанг, менеджер HPC продукта Xilinx, объяснил, что многие рабочие нагрузки теперь memory-bandwidth bound вместо compute bound. «Мы подстригли карту до однослотного форм-фактора и удвоили ее HBM, добавив способность масштабироваться через сотни карт так, что вся эта полоса пропускания может быть использована», — сказал он.
Он добавил: «Разблокировка полосы пропускания через кластеры была вызовом. Разработчики ранее должны были дизайнить свои собственные кластеризационные решения. С нашим открытыми-стандартами пакетом — использующим RoCE v2 и Data Center Bridging через Ethernet с 200 Гбит/с на карту — пользователи теперь могут строить кластеры, соперничающие InfiniBand в производительности и задержке без вендор-лок-ин».
«Это значит, что в существующей дата-центр инфраструктуре вы можете установить эти карты в текущих серверах, использовать ваш существующий Ethernet fabric и конкурировать с InfiniBand на обоих скорости и стоимости», — продолжил Чанг.
Другая выгода — Vitis теперь более доступен для разработчиков. Высокоуровневые языки такие как C, C++ и Python, также как основные AI фреймворки вроде PyTorch и TensorFlow, могут таргетить Alveo без требования RTL или Verilog экспертизы.
Особенности Alveo U55C для HPC и Big Data
U55C комбинирует несколько ключевых атрибутов, которые современные HPC рабочие нагрузки требуют:
- Высшая вычислительная плотность и 16 ГБ HBM2 — удвоенная емкость предыдущего двухслотного U280.
- Один-слот полная-высота, половина-длина (FHHL) форм-фактор с максимумом 150 Вт мощности.
- Превосходная параллелизм данных-пайплайна, управление памятью и оптимизация движения данных для максимума производительность-на-ватт.
- 200 Гбит/с RoCE v2 нетворкинг, соперничающий с InfiniBand в задержке и полосе пропускания.
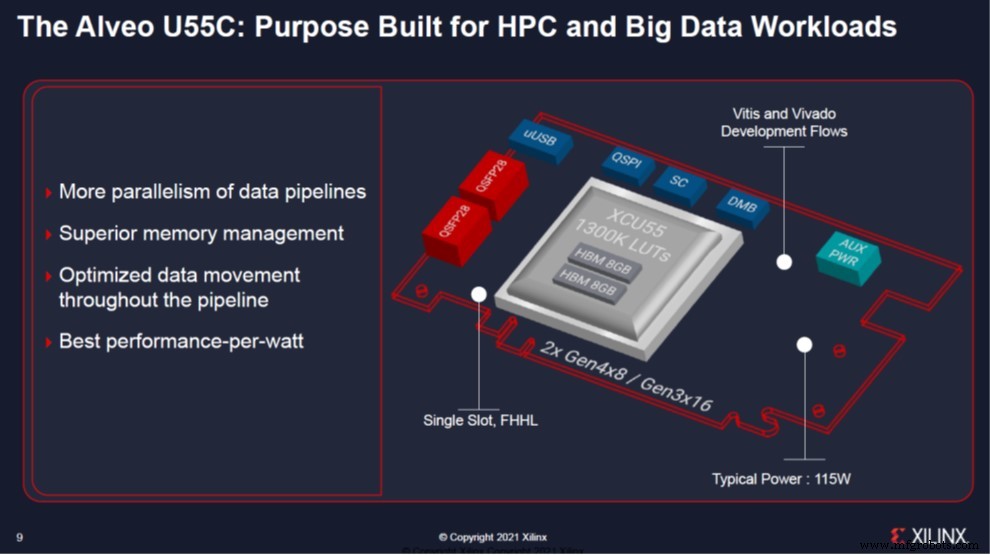
API-драйвенное кластеризационное решение, построенное на RoCE v2 и Data Center Bridging, позволяет пользователям строить плотные Alveo сети, масштабируемые через сотни карт — независимо от серверной платформы или сетевого fabric — при совместном использовании рабочих нагрузок и памяти. MPI интеграция от Xilinx Vitis единой программной платформы позволяет разработчикам бесшовно масштабировать данные пайплайны.
Программные инженеры и данные ученые могут использовать высокоуровневую программируемость платформы Vitis. Xilinx сильно инвестировала в Vitis для снижения барьера входа для адаптивных вычислений. С поддержкой PyTorch, TensorFlow, C, C++ и Python, разработчики могут ускорять критические HPC рабочие нагрузки в своих существующих дата-центр средах.
Кто использует U55C?
Чанг подчеркнул несколько proof-of-concept развертываний.
CSIRO, Австралия
Проект Square Kilometre Array CSIRO использует 420 U55C карт для реальное-времени сигнальной обработки от 131 000 антенн. Кластер — сетевой через P4-включенные 100 Гбит/с коммутаторы — доставляет 460 Гбит/с HBM2 полосы пропускания и 15 Тбит/с агрегатной пропускной способности в компактном, энергоэффективном след.
Ansys LS-DYNA
Автомобильные безопасностные симуляции выигрывают от более чем 5x ускорения над x86 CPU когда LS-DYNA запускается на кластеризованных U55C картах. Гипер-параллелизируя данные пайплайны, решатель обрабатывает сотни миллионов степеней свободы более эффективно, драматически снижая время симуляции.
TigerGraph
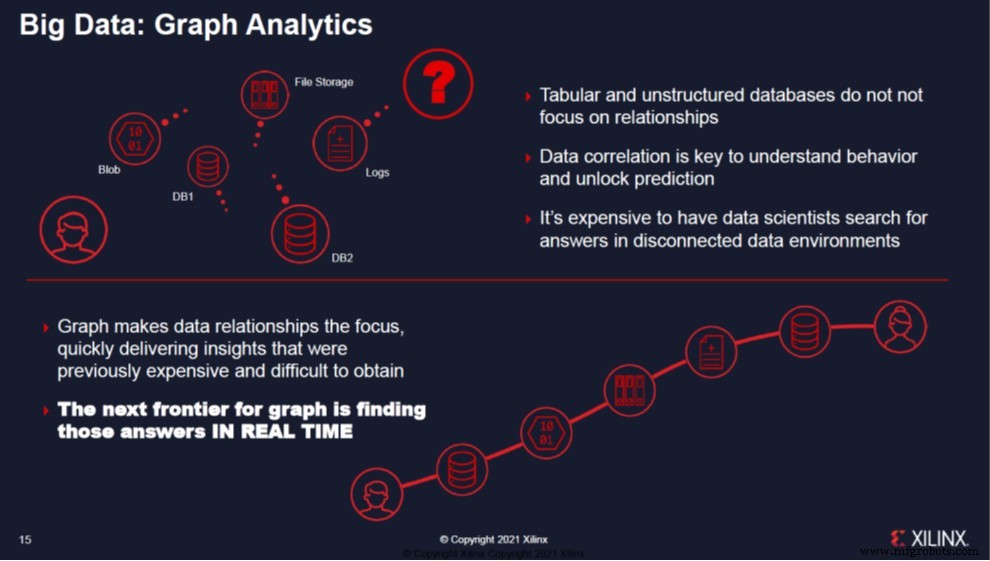
Граф-аналитические рабочие нагрузки видят до 45x быстрее запрос времени и 35% выше рекомендательную точность когда ускорены множественными U55C картами, режущие предсказательную задержку от минут до миллисекунд.
Alveo U55C теперь доступен через веб-сайт Xilinx и авторизованных дистрибьюторов. Он также может быть оценен через облачные FPGA-as-a-service платформы и выбранные колокационные дата-центры. Кластеризация доступна для частного превью, с общей доступностью, запланированной на Q2 следующего года.
Встроенный
- Siemens расширяет систему Veloce четырьмя новыми продуктами, обеспечивая бесшовную аппаратно-ускоренную верификац…
- TI представила чипы с BAW-резонаторами для революции в связности следующего поколения
- DATA MODUL запускает гибридную технологию склеивания для промышленных сенсорных дисплеев высоких объемов
- Военные SSD от Cervoz: надежное хранение для миссионно‑критичных оборонных и аэрокосмических применений
- CEVA представляет NeuPro‑S:.next‑gen AI процессор для edge‑выводов глубоких нейросетей
- Kontron представляет COM HPC: новый стандарт высокопроизводительных встроенных вычислений
- acceed EDAM-4200: Интегрированные I/O-модули для масштабируемой надежной передачи данных
- Топ-4 вызова, стоящие перед Индустриальным Интернетом вещей (IIoT)
- Может ли Big Data революционизировать бюджеты здравоохранения? Инсайты от Lux Research
- Big Data и ИИ: синергия за цифровой трансформацией