



Data Lake vs Big Data: выбор подхода для промышленных применений
Data Lake и Big Data — современные термины, часто путаемые и используемые неверно. Из-за подразумеваемых больших объёмов их иногда приравнивают. Но это разные понятия, хотя определения ещё не до конца устоялись.
Рисунок 1. Современные данные приходят из множества источников и разного типа. Источник: Analytics Vidhya
Краткий исторический контекст. Конец 2000-х: взрыв соцсетей (Facebook, Twitter) — дата-сайентисты увидели потенциал генерации массивов персональных данных. Появился софт для обработки. Яркий пример — Apache Hadoop, тулкит open-source для Big Data.
Следующее десятилетие — IoT. Миллионы новых источников: предпочтения людей, паттерны поведения, телеметрия самих устройств.
Параллельно machine learning прорвался в промышленность. Вырос спрос на обработку больших объёмов в автоматизированных процессах.
Все прогнозы: объём данных в мире будет расти ускоренно. Для справки: 2016 год — преодолён 1 Зеттабайт годового интернет-трафика (1 трлн ГБ). К 2021 — ожидается >3 ЗБ. Вместе с расширением облаков ценность Big Data и Data Lake только начинает раскрываться.
Что такое Big Data?
С точки зрения объёма — подвижная цель. Растут данные и хранилища — растёт планка «большого».
Сегодня репозиторий 100+ ТБ — уже Big Data. Соцсети — в петабайтах.
Другой критерий: когда традиционные инструменты (SQL) не справляются. Сейчас 1 ТБ/год для БД — норма, SQL стал мощнее, такое не считают Big Data.
Модель 4V Big Data
Помимо Volume (объём) — три фактора: Velocity (скорость), Variety (разнообразие), Veracity (достоверность). Вместе — 4V.
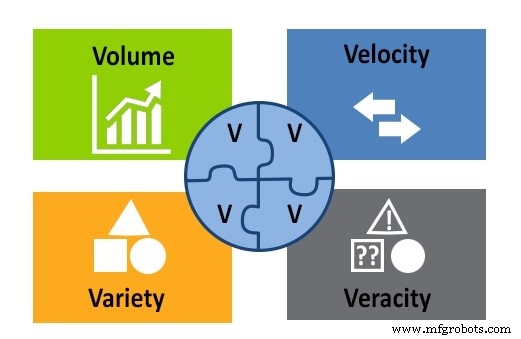
Рисунок 2. 4V модель: Volume, Velocity, Variety, Veracity. Источник: APSense
Variety — все типы данных в репозитории: текст, изображения, звук, видео. И множественные источники.
Velocity — данные текут постоянно. Важно: скорость сбора, генерации, распространения.
Veracity — точность и качество для пригодности к анализу и выводам.
Теперь Data Lake перед погружением в промышленные кейсы.
Что такое Data Lake?
Централизованные репозитории больших объёмов сырых данных — информации, которая может пригодиться в будущем, но её цель пока неясна на 100%. Хранят реляционные и нереляционные БД, файлы, сущности.
Данные не обработаны и не организованы, но структурированы так, что все входы/выходы учтены для хорошей архитектуры.
Data Lake vs Big Data
Data Lake — экземпляр Big Data-приложения. Следует 4V с особенностями. По объёму — в среднем на нижней границе Big Data.
Разнообразие есть, но условие — только сырые необработанные данные. Скорости ввода/вывода актуальны как в любой современной системе. Оценка качества выполняется в грамотно спроектированном Data Lake.
Промышленные применения данных
Продвинутая автоматизация взрывает объём информации на цехах. Производство и промышленность входят в эру Big Data, бизнес-активности используют Data Lake.
Яркий пример — предиктивное обслуживание. Способность предсказать механический/электрический сбой — огромная экономия на ремонтах. Data Lake собирает логи, датчики, вводные устройства — для понимания трендов и прогноза проблем.
Machine Learning — роботы получают данные для адаптации к меняющимся условиям. Сбор похож на предиктивку, плюс оценки и изменения автоматически уходят в контроллер. ML-данные хранят в структурированном Data Lake.
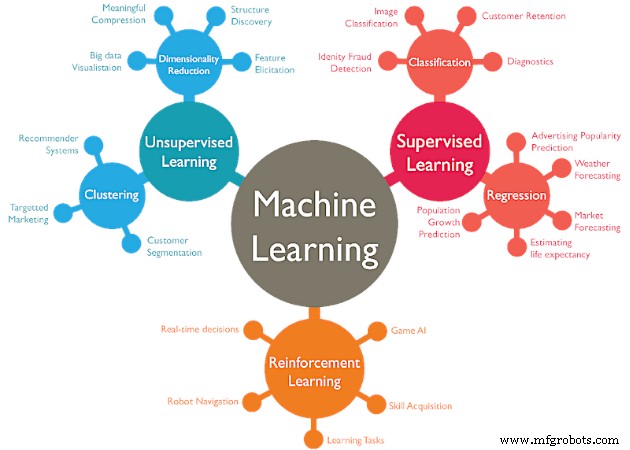
Рисунок 3. ML-стратегии требуют много данных. Источник: WordStream
Итог: Data Lake — это экземпляр Big Data. Два подхода работают вместе. Используя и то, и другое, инженер управления предсказывает сбои, создаёт режимы обслуживания, растит цифровую трансформацию завода и многое другое.
Для чего вы используете Big Data и Data Lake в работе?
Интернет вещей
- Как подключенные сенсоры и умные процессоры движут Индустрию 4.0
- Руководство Cervoz: выбор надежного флеш-хранилища для промышленных приложений
- GE запустила Predix Cloud: выделенная платформа для промышленных данных и аналитики
- Будущий взгляд: продвижение Industrial IoT для производственного превосходства
- Топ-4 вызова, стоящие перед Индустриальным Интернетом вещей (IIoT)
- Шесть ключевых принципов построения высоковлиятельных сенсор-драйвенных IoT-приложений
- Использование RTU для получения инсайтов из больших данных в промышленных операциях
- Строительство фундаментов для успеха промышленного Data Science
- Промышленный IoT: от сбора данных к принятию решений в реальном времени
- Может ли Big Data революционизировать бюджеты здравоохранения? Инсайты от Lux Research