



Система избегания препятствий с ИИ (Q-learning) на Arduino и ультразвуковых датчиках
Компоненты и материалы
| SparkFun Arduino Pro Mini 328 - 5V/16MHz | 1 |
| Ультразвуковой датчик HC-SR04 | 1 |
| Драйвер двигателей L298 (Dual H-Bridge) | 1 |
| DC мотор 60 RPM | 2 |
| Колеса | 4 |
| Перемычки | 1 комплект |
| Паяльная плата (мини) | 1 |
| Литий-ионный аккумулятор 7.2В | 1 |
| Крона 9В + держатель | 1 |
| PCBWay Custom PCB | 1 |
| Кнопка JS Series | 1 |
Инструменты
- Паяльник, припой, флюс, отсасыватель
- Обкусыватель/стриппер
- Клеевой пистолет, двусторонний скотч
Приложения
- Arduino IDE
О проекте
Робот-искатель пути с обучением с подкреплением (Q-learning)
Задача: Робот должен научиться избегать препятствий за N эпизодов, находя оптимальное действие (в данном случае — поворот вправо).
Алгоритм: Q-learning — модель обучения с подкреплением без учителя.
Принцип работы L298N
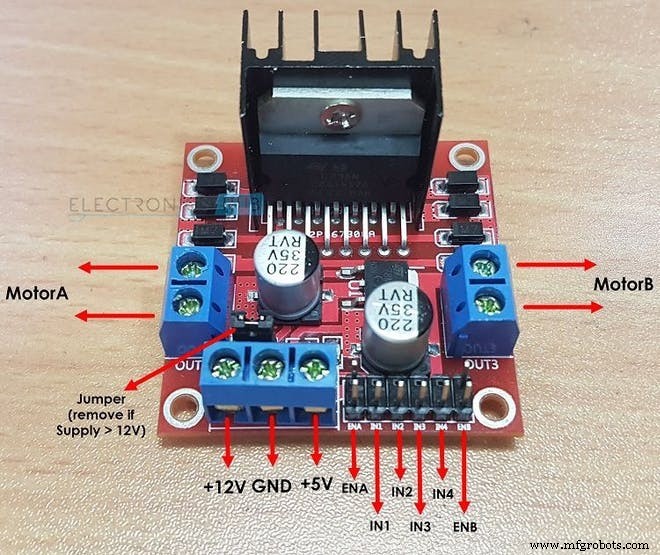
Драйвер L298N управляет двумя DC-моторами независимо, позволяя двигаться вперед, назад, поворачивать.
Принцип работы HC-SR04
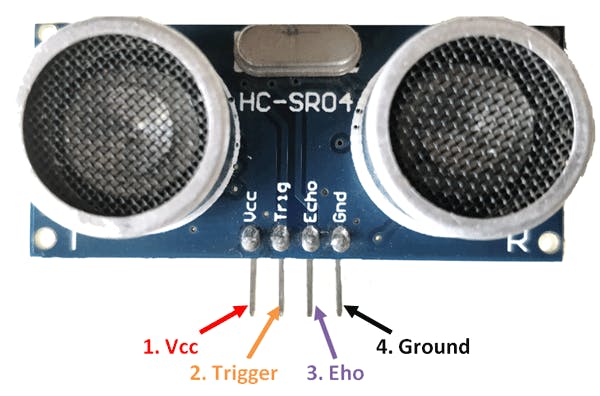
Датчик измеряет расстояние по времени прохождения ультразвукового импульса.
Ключевые термины обучения с подкреплением
- STATE (Состояние): ситуация робота. Здесь 2 основных состояния: препятствия нет (состояние 0) и препятствие близко (состояние 1). В коде для иллюстрации сложной среды используется 10 состояний, все ожидают одно действие.
- ACTION (Действие): в состоянии «препятствие близко» робот может: FORWARD (0), BACKWARD (1), STOP (2), RIGHT (3). В состоянии «препятствия нет» — только FORWARD.
- NEXT STATE (Следующее состояние): после действия робот попадает в состояние CRASHED или SURVIVED (возврат к начальному).
- Q-TABLE (Q-матрица): таблица размером [STATES × ACTIONS], хранящая ценность действий. Инициализируется нулями. Значение -1.0 запрещает действие в данном состоянии.
- TERMINAL STATE: конечное состояние. Здесь его нет — робот обучается бесконечно.
- REWARD MATRIX (Матрица наград): награды за действия. Пример: FORWARD при препятствии = -10, RIGHT = +10, STOP = -1, BACKWARD = -2.
- ENVIRONMENT (Среда): мир робота (поле с препятствиями).
Гиперпараметры Q-learning
- LEARNING RATE (ALPHA) = 0.1: степень обновления старых знаний новой информацией.
- DISCOUNT FACTOR (GAMMA) = 0.5: важность будущих наград.
- EXPLORATION RATE (EPSILON) = 0.9: вероятность случайного действия (exploration). Со временем уменьшается (decay), но сбрасывается при падении ниже 0.5 для постоянного исследования.
Алгоритм Q-learning
- Инициализация Q-таблицы нулями.
- Наблюдение текущего состояния s.
- Выбор действия a по ε-жадной политике: с вероятностью ε — случайное действие (exploration), иначе — действие с макс. Q(s,a) (exploitation).
- Выполнение действия, получение награды r и нового состояния s'.
- Обновление Q-значения по формуле Беллмана:
Q_NEW = (1-ALPHA)*Q_OLD + ALPHA*(r + GAMMA*max(Q(s',a'))) - Переход в новое состояние, повтор до терминального состояния (или бесконечно).

Рабочее видео
Демонстрация работы робота доступна в исходном проекте.
Исходный код (C/C++ для Arduino)
Полный скетч с комментариями. Реализует обучение (training), оценку (evaluation) и тестирование (testing).
/* Obstacle Avoiding Robot using Reinforcement Learning / AI
   Author: Varun Walimbe
   Algorithm: Q learning
   Hardware: Arduino Pro Mini, HC-SR04, L298N, 2x DC motors
*/

////////// HARDWARE PARAMETERS //////////
int TRIG_PIN = 7;
int ECHO_PIN = 8;
int duration;
float distance;
int M1 = 13, M2 = 12, M3 = 11, M4 = 10;
bool Obstacle = false;
int FLAG;

////////// Q-LEARNING PARAMETERS //////////
float ALPHA = 0.1;      // Learning rate
float GAMMA = 0.5;      // Discount factor
float EPSILON = 0.90;   // Exploration rate
int REWARD;
int EPISODES = 100;
int STATE = 0;
int ACTION = 0;         // 0:FORWARD, 1:BACKWARD, 2:STOP, 3:LEFT
float PROB;
bool ACTION_TAKEN = false;
int NEXT_STATE;
const int STATES = 10;
int ACTIONS[4] = {1,2,3,4};
const int NUMBER_OF_ACTIONS = 4;

// Q-table
float Q[STATES][NUMBER_OF_ACTIONS] = {
  {0,0,0,0}, {0,0,0,0}, {0,0,0,0}, {0,0,0,0}, {0,0,0,0},
  {0,0,0,0}, {0,0,0,0}, {0,0,0,0}, {0,0,0,0}, {0,0,0,0}
};

// Reward matrix
int REWARDS[STATES][NUMBER_OF_ACTIONS] = {
  {-10,-2,-1,10}, {-10,-2,-1,10}, {-10,-2,-1,10}, {-10,-2,-1,10}, {-10,-2,-1,10},
  {-10,-2,-1,10}, {-10,-2,-1,10}, {-10,-2,-1,10}, {-10,-2,-1,10}, {-10,-2,-1,10}
};

////////// Q-LEARNING UPDATE PARAMS //////////
float Q_OLD, Q_NEW, Q_MAX;

void setup() {
  Serial.begin(9600);
  pinMode(TRIG_PIN, OUTPUT);
  pinMode(ECHO_PIN, INPUT);
  pinMode(M1, OUTPUT); pinMode(M2, OUTPUT);
  pinMode(M3, OUTPUT); pinMode(M4, OUTPUT);
  randomSeed(analogRead(A0));
  STATE = 0;
  Serial.println("TRAINING WILL START IN 5 SECONDS:");
  delay(5000);
}

//////// ROBOT MOVEMENT FUNCTIONS ////////
void Forward()  { digitalWrite(M1,LOW); digitalWrite(M2,HIGH); digitalWrite(M3,LOW); digitalWrite(M4,HIGH); }
void Backward() { digitalWrite(M1,HIGH); digitalWrite(M2,LOW); digitalWrite(M3,HIGH); digitalWrite(M4,LOW); }
void Left()     { digitalWrite(M1,HIGH); digitalWrite(M2,LOW); digitalWrite(M3,LOW); digitalWrite(M4,HIGH); }
void Right()    { digitalWrite(M1,LOW); digitalWrite(M2,HIGH); digitalWrite(M3,HIGH); digitalWrite(M4,LOW); }
void Stop()     { digitalWrite(M1,LOW); digitalWrite(M2,LOW); digitalWrite(M3,LOW); digitalWrite(M4,LOW); }

bool Obstacle_Avoider() {
  digitalWrite(TRIG_PIN, HIGH);
  delayMicroseconds(10);
  digitalWrite(TRIG_PIN, LOW);
  duration = pulseIn(ECHO_PIN, HIGH);
  distance = (duration/2)/29.1;
  if (distance < 15) Obstacle = true;
  else Obstacle = false;
  delay(10);
  return Obstacle;
}

//////// Q-LEARNING HELPER FUNCTIONS ////////
float RANDOM(float EXPLORATION_PARAMETER) {
  float RANDOM_VARIABLE = random(0,100);
  return RANDOM_VARIABLE/100;
}

float DECAY(float PARAMETER) {
  return PARAMETER * 0.98; // уменьшение epsilon
}

int GET_STATE() {
  return random(0,10); // случайное состояние для демонстрации
}

float MAX(float Q_Table[][4], int NEXT_S) {
  float MAX_VALUE = 0;
  for (int b=0; b<=3; b++) {
    if (Q_Table[NEXT_S][b] > MAX_VALUE) MAX_VALUE = Q_Table[NEXT_S][b];
  }
  return MAX_VALUE;
}

int ARGMAX(float Q_Table[][4], int S) {
  float MAX_VALUE = 0;
  int MAX_INDEX = 0;
  for (int u=0; u<=3; u++) {
    if (Q_Table[S][u] > MAX_VALUE) {
      MAX_VALUE = Q_Table[S][u];
      MAX_INDEX = u;
    }
  }
  return MAX_INDEX;
}

void Update(float Q_TABLE[][4], int S, int NEXT_S, int A, int ACTIONS[], int R, float LEARNING_RATE, float DISCOUNT_FACTOR) {
  Q_OLD = Q_TABLE[S][A];
  Q_MAX = MAX(Q_TABLE, NEXT_S);
  Q_NEW = (1-LEARNING_RATE)*Q_OLD + LEARNING_RATE*(R + DISCOUNT_FACTOR*Q_MAX);
  Serial.print("Q VALUE: "); Serial.println(Q_NEW);
  Q_TABLE[S][A] = Q_NEW;
}

//////// MAIN LOOP ////////
void loop() {
  ///// TRAINING /////
  for (int I=0; I
Схемы
Файл схемы для Fritzing: obstacle_avoiding_robot_using_ai_DcoMCWIOFm.fzz
Управление яркостью LED с ШИМ через кнопку на Arduino Mega
Сборка DCC-командной станции для модельной железной дороги на Arduino с бесплатным приложением
Производственный процесс
- Arrow Electronics запускает AI Experience Tour с Intel, Microsoft, Nvidia
- Визионный мобильный робот, избегающий препятствия, на Raspberry Pi
- Bosch представляет ИИ‑решение для производства на Hannover Messe
- Искусственный интеллект в ритейле: доказанные выгоды, а не модная волна
- Kubernetes усиливает AI-стартапы масштабируемыми контейнеризированными решениями
- Как ИИ трансформирует ландшафт Интернета вещей
- Искусственный интеллект еще не готов для кибербезопасности промышленных систем управления
- ИИ предсказывает квантовое преимущество: нейросеть прогнозирует поведение систем
- ИИ для отслеживания вырубки лесов в Амазонке
- Робототехника на базе ИИ: передовая интеллектуальная машина