



Инсайты отрасли 2021: исчерпывающее обновление за март 2021 года
Введение
Поскольку наши ежедневные обновления загрузки набирают обороты и привлекают больше внимания, мы считаем важным, как хранители данных, прояснить наши допущения, любые источники смещения, которые у нас могут быть, и наши погрешности, чтобы организации могли принимать наиболее обоснованные решения из наших цифр.
Как и с любым набором данных, наши данные содержат смещение, поэтому мы прилагаем погрешность к любым отчитываемым метрикам. Важно, как практикам данных, быть прозрачными об этих источниках смещения, наших допущениях о данных и о том, как мы адресуем эти проблемы в нашей методологии. Это позволяет вам, пользователю, делать свои собственные суждения о достоверности наших утверждений и ценности наших данных для вашей организации.
Аналогия с традиционными методами опросов
Если рассматривать наш набор данных с точки зрения традиционных опросов (как вы видите по телевизору, кто впереди в президентских праймериз), мы можем считать каждый из наших станков «человеком», которого мы «опрашиваем». Вопрос, который мы задаем для этого опроса, прост: «Какова была ваша средняя загрузка за последние семь дней?» Мы опрашиваем тысячи «людей» (станков) по всем США каждую секунду через наш парк облачно подключенных Edge-устройств, и отчитываем эту цифру за предыдущий день, когда все «ответы» «поступили».
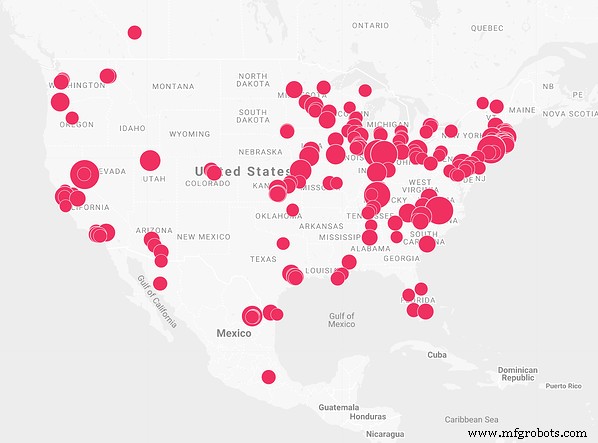 Где находятся «люди» (станки), которых мы опрашиваем.
Как и любой опрос, не охватывающий всю популяцию, наша выборка подвержена смещению. Как адресовалось в наших предыдущих постах, определенные формы смещения не применимы в нашей методологии — а именно эмоционально-обусловленные, как смещение восприятия, подтверждения и злонамеренное отчетность. Станки опрашиваются автоматически через ПО каждую секунду — они не могут «врать» или говорить неправду, потому что нет возможности сделать это, когда они привязаны к MachineMetrics. Технологические сбои номинальны, так как загрузка — самая базовая метрика, которую мы опрашиваем у станков, и любые аномалии алгоритмически обнаруживаются и быстро устраняются. Однако другие формы смещения все равно существуют даже когда вы убираете человеческий элемент.
Выборка высокой продуктивности
Во-первых, наша выборка, вероятно, представляет выборку высокой продуктивности в производстве. Это потому, что те, кто внедряет технологии Индустрии 4.0 — это цеха, которые более прогрессивны, и поэтому, вероятно, уже имеют процессы для оптимизации операций и увеличения пропускной способности. Мы не полностью уверены, на сколько процентных пунктов наша выборка более продуктивна, чем «среднее» дискретное производство, но мы не верим, что общие тренды должны быть затронуты этим (то есть процентное изменение день к дню должно быть похожим для выборки высокой продуктивности и выборки средней продуктивности). Это потому, что макро-факторы вроде праздников, экономических шоков и оншоринга/оффшоринга должны влиять на цеха с высокой и низкой продуктивностью относительно одинаково. Это важно, потому что хотя общий уровень загрузки, который мы отчитываем, слегка завышен, мы все равно видим очень четкие тренды: эффект праздников, эффект коронавируса и эффект накопленного потребительского спроса на производство в целом.
Кроме того, мы не захватываем идеальный переписной учет использования станков по США, так как это потребовало бы подключения ко всем 3 миллионам+ станков (цифра 3 миллиона идет от Ассоциации технологий производства, которая оценивает, что работает 3,2 млн ЧПУ-станков с оригинальной стоимостью более $50 тыс.).
Пока мы стремясь дойти до 3 миллионов, сейчас мы должны довольствоваться долей этого общего размера. Мы не раскрываем точный размер выборки, потому что мы взимаем стандартную цену за станок, и это раскрыло бы нашу годовую повторяющуюся выручку, цифру, которую большинство стартапов нашего размера не готовы раскрывать, потому что она играет ключевую роль в оценках.
Погрешность
Однако мы включаем погрешность как лучшую практику, к чему и стремится размер выборки. Погрешность учитывает размер выборки как пропорцию от общего размера популяции, а также процент респондентов, ответивших утвердительно на опрос. В нашем случае нет «утвердительного» ответа — мы теоретически могли бы считать 100% загрузку «все сказали да» и 0% — «все сказали нет», но это подозрительно. Поэтому мы просто используем 50% пропорцию для утвердительных ответов в нашем расчете, что максимизирует погрешность для самых консервативных мер точности опроса. Вы можете быть уверены, что отчитываемые нами marges — для худшего сценария при нашем размере выборки.
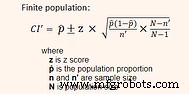 Формула погрешности для конечных популяций. Источник: Chegg Homework Help
Чем больше погрешность, тем меньше уверенности пользователи должны иметь в результатах опроса. Наша текущая погрешность колеблется около ±1,6% до ±1,8%. То есть мы на 95% уверены, что для всех 3 миллионов станков в США фактические цифры загрузки находятся в пределах ±1,6% до ±1,8% от того, что мы отчитываем. Наша последняя отчитываемая цифра загрузки за 6 марта 2021 года была 29,41%, что означает, что мы считаем очень вероятным, что фактическая загрузка для всей популяции станков находится между 27,60% и 31,21%. Это значит, что сравнения, происходящие в пределах погрешности, как и результаты опросов между двумя кандидатами в пределах погрешности, должны рассматриваться с осторожностью. Думаю, мы все выучили это на личном опыте во время цикла выборов 2016 года.
Например, если загрузка меняется с 29,0% на 29,4%, это все еще в пределах нашей погрешности и должно рассматриваться скорее как любопытство, чем как факт. Если же это изменение сохраняется много дней и загрузка меняется с 29% на 31% в течение недели, мы на 95% уверены, что это отражает популяционное изменение. В другом случае, если это пятница перед 4 июля и загрузка меняется с 29% на 25% за день, это тоже больше, чем просто любопытство, а отражает реальность на цехах по всей США (люди берут выходной в пятницу перед 4 июля, чтобы начать выходные раньше).
Цифра ±1,6–1,8% также важна сама по себе. Это буфер, который вы должны установить для себя, если бенчмарките загрузку своего завода против отраслевых норм.
Обновление по отраслевым условиям
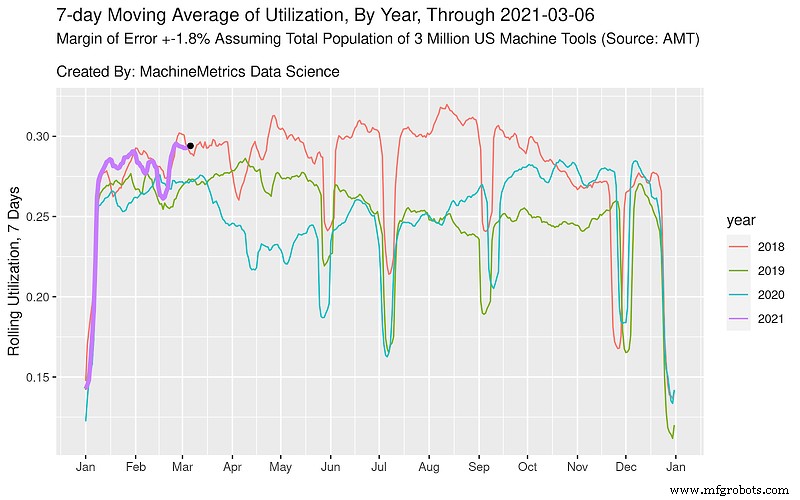
В духе нашего прояснения погрешности, мы хотим заявить загрузку следующим образом:
Мы на 95% уверены, что скользящее недельное среднее загрузки через вчера находится между 27,60% и 31,21%, с точечной оценкой 29,41%.
Это отражает данные ФРС, показывающие, что спрос на заводы по всей стране растет из-за накопленного спроса. Мы видим, что это самая высокая загрузка 6 марта за последние четыре года — довольно невероятный инсайт.
Это также представляет локальный максимум, который не был превзойден с октября 2018 года (максимум за 41 месяц). Это почти идеально совпадает с индексом производства ISM, который также достиг 48-месячного максимума 60,8 после скачка с 58,7 в январе. Данные подтверждаются анекдотическими отчетами об остром дефиците рабочей силы в производстве, так как владельцы заводов борются за найм рабочих при усиленной конкуренции от Amazon и др. Менеджеры цехов повышают зарплаты на 30%, чтобы конкурировать за таланты, пока новые игроки приходят нанимать квалифицированных рабочих.
Мы завершаем ссылкой на подкаст в Wall Street Journal, который добавляет человеческий контекст к тому, что мы видим в наших данных: Where Jobs are Booming.
В заключение, бизнес идет хорошо, почти слишком хорошо. Пожалуйста, следите за дальнейшими обновлениями!
Промышленные технологии
- Перспективы авиакосмической отрасли Калифорнии 2017: рост и возможности
- Три критически важных урока, извлеченные пищевой промышленностью в 2021 году
- Тренды производства 2021: Часть 2 — инсайты от Make UK
- Индустрия 4.0 и устойчивое развитие: навигация экологических вызовов
- Индустрия 5.0: переосмысление производства для будущего
- Внедрение стратегии качества для усиления конкурентоспособности промышленности
- Эффективный обмен знаниями между поколениями в современной промышленности
- Как визуальное управление ведет к успеху в Индустрии 4.0
- 5 мощных выгод обмена знаниями для роста промышленности
- Цифровое производство: формирование промышленности завтрашнего дня