



Построение вариационного автоэнкодера с TensorFlow: практическое руководство
Освойте основы автоэнкодеров, узнайте, как вариационные автоэнкодеры их улучшают, и пройдите пошаговую реализацию на TensorFlow.
Искусственный интеллект переформировал бесчисленные сферы, и сжатие данных — не исключение. Автоэнкодеры — особенно их вариационные варианты — предоставляют мощные генеративные схемы сжатия, которые одновременно эффективны и выразительны. Это руководство раскладывает ключевые концепции и ведёт через полную TensorFlow-реализацию на датасете MNIST.
Применения автоэнкодеров
Автоэнкодеры широко приняты в областях от нейронного машинного перевода до открытия лекарств, шумоподавления изображений и обнаружения аномалий. Их способность обучать компактные, информативные представления делает их goto-инструментом для современных ML-пайплайнов.
Ключевые компоненты автоэнкодера
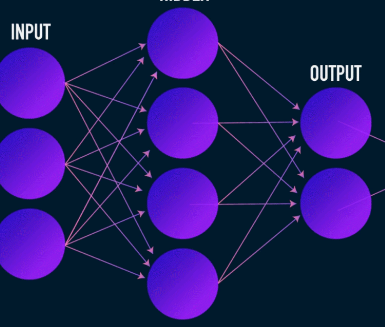
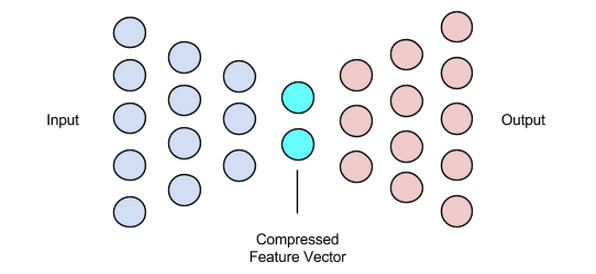
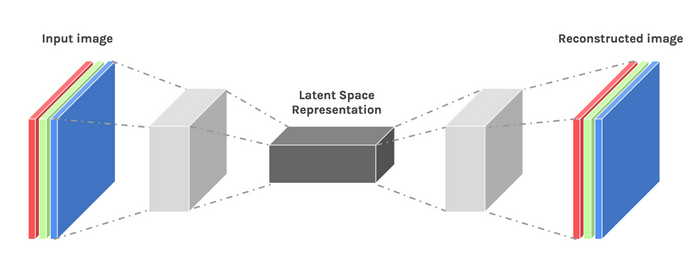
В отличие от типичных нейронных сетей, автоэнкодеры имеют «бутылочное горлышко», принуждающее к низкоразмерному латентному представлению. Архитектура состоит из трёх основных частей:
- Энкодер — сжимает входные данные в латентный вектор.
- Бутылочное горлышко (Латентный вектор) — хранит наиболее салиентные признаки.
- Декодер — восстанавливает вход из латентного вектора.
Энкодер и декодер обычно являются feed-forward сетями, но специализированные варианты — свёрточные для изображений, рекуррентные для текста — обычны в практике.
Энкодер
Энкодер отображает высокоразмерные входы (например, 28×28 пикселей) в компактный латентный вектор. Во время обучения он оптимизирует веса так, чтобы латентный вектор захватывал существенную информацию, позволяя декодеру восстанавливать вход с минимальными потерями.
Бутылочное горлышко (Латентный вектор)
Размер латентного вектора — компромисс: слишком мал — теряете критические детали; слишком велик — подрываете сжатие и раздуваете вычисления. Выбор подходящей размерности критичен для производительности модели.
Декодер
Декодер зеркалит энкодер, трансформируя латентный вектор обратно в исходное пространство данных. Обычно использует транспонированные свёртки или апсэмплинг для восстановления пространственного разрешения.
Обучение автоэнкодеров
Автоэнкодеры обучаются end-to-end с градиентными оптимизаторами вроде Adam. Цель — минимизировать функцию потерь восстановления, количественно измеряющую расхождение между входом и его восстановлением.
Функции потерь
Частые выборы: L1, L2, среднеквадратичная ошибка (MSE). Каждая измеряет, насколько выход близок к входу, делая их подходящими для генеративных задач восстановления.
Варианты сетей
Хотя многослойные перцептроны (MLP) могут служить энкодерами/декодерами, свёрточные нейронные сети (CNN) предпочтительны для изображений благодаря пространственному пониманию. Рекуррентные сети отлично работают с последовательными данными, например текстом.
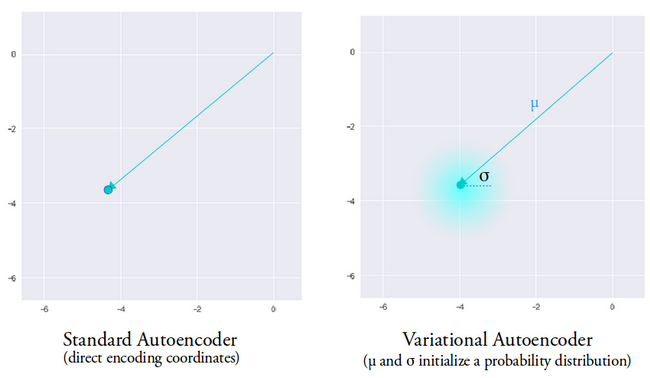
Стандартные автоэнкодеры лишены креативности — они могут только воспроизводить данные, увиденные во время обучения. Введение стохастичности через вариационный фреймворк раскрывает генеративные способности.
Вариационные автоэнкодеры (VAE)
VAE модифицируют стандартную архитектуру двумя способами:
- Энкодер выдаёт вектор среднего и вектор дисперсии, определяя Гауссово распределение.
- Член расхождения Кульбака-Лейблера (KL) добавляется к потере для регуляризации латентного распределения к стандартному Гауссову.
Во время инференса энкодер сэмплирует латентный вектор из выученного распределения, позволяя декодеру генерировать разнообразные, реалистичные восстановления. Эта стохастичность смягчает разрывы, часто наблюдаемые в детерминированных автоэнкодерах.
Реализация на TensorFlow
Ниже представлена лаконичная, готовая к продакшену TensorFlow-реализация свёрточного VAE, обученного на MNIST.
Подготовка данных
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape(-1, 28, 28, 1).astype('float32')
test_images = test_images.reshape(-1, 28, 28, 1).astype('float32')
train_images /= 255.
test_images /= 255.
train_images[train_images >= .5] = 1.
train_images[train_images < .5] = 0.
test_images[test_images >= .5] = 1.
test_images[test_images < .5] = 0.
TRAIN_BUF = 60000
BATCH_SIZE = 100
TEST_BUF = 10000
train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE)
test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
Определение модели VAE
class CVAE(tf.keras.Model):
    def __init__(self, latent_dim):
        super(CVAE, self).__init__()
        self.latent_dim = latent_dim
        self.inference_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(28, 28, 1)),
            tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'),
            tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'),
            tf.keras.layers.Flatten(),
            tf.keras.layers.Dense(latent_dim + latent_dim), # mean & logvar
        ])
        self.generative_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(latent_dim,)),
            tf.keras.layers.Dense(7*7*32, activation='relu'),
            tf.keras.layers.Reshape((7, 7, 32)),
            tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'), # logits
        ])
    @tf.function
    def sample(self, eps=None):
        if eps is None:
            eps = tf.random.normal(shape=(100, self.latent_dim))
        return self.decode(eps, apply_sigmoid=True)
    def encode(self, x):
        mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1)
        return mean, logvar
    def reparameterize(self, mean, logvar):
        eps = tf.random.normal(shape=mean.shape)
        return eps * tf.exp(logvar * .5) + mean
    def decode(self, z, apply_sigmoid=False):
        logits = self.generative_net(z)
        if apply_sigmoid:
            return tf.sigmoid(logits)
        return logits
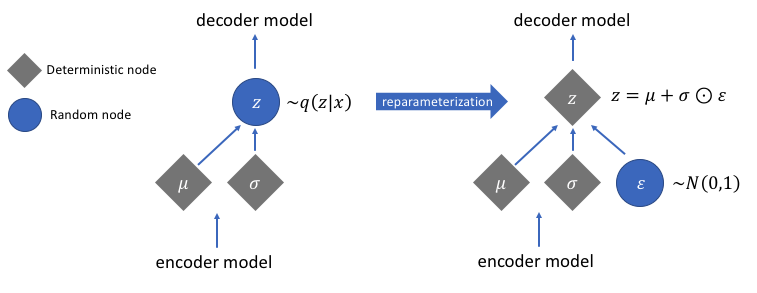
Ключевые вспомогательные функции — encode, reparameterize и decode — инкапсулируют рабочий процесс VAE. Метод reparameterize реализует трюк репараметризации, позволяя градиентам течь через стохастическое сэмплирование.
Трюк репараметризации
Прямое сэмплирование латентного вектора из распределения ломает дифференцируемость. Выражая сэмпл как z = mean + std * eps где eps ~ N(0,1), градиенты распространяются через mean и std. Член KL-дивергенции дополнительно выравнивает выученное распределение со стандартным нормальным, способствуя гладким латентным пространствам.
Краткое резюме шагов
- Определите архитектуры энкодера и декодера.
- Реализуйте трюк репараметризации для включения обратного распространения.
- Обучите модель end-to-end, минимизируя потерю восстановления плюс KL-дивергенция.
Для полного кода и дополнительных скриптов обучения посетите официальное руководство TensorFlow.
Автор изображений: Chiman Kwan (модифицировано)
Промышленный робот
- Как 3D-принтеры печатают металлические детали: от порошка к точности
- Сокращение отходов и энергозатрат с автономными роботами
- Защита облачных технологий: лучшие практики для защиты данных и митигации рисков
- Использование данных в Интернете надежности: стратегии эффективного управления
- Использование IoT для HVAC Big Data: оптимизация энергии, комфорта и качества воздуха — Часть 2
- Оживление IoT с IBM и Tech Data — Часть 2
- Превращение IoT в реальность: инсайты Tech Data и IBM — Часть 1
- AI-дорожные карты: стратегическое руководство для компаний цепочек поставок
- Использование интеллектуального анализа данных и ИИ: план промышленных брендов для процветания в электронно…
- Оптимизация срока службы инструмента с данными станка: современное руководство