



Локальные минимумы в обучении нейронных сетей: миф или реальность?
Понимание роли локальных минимумов в обучении перцептронов и многослойных нейронных сетей.
В серии AAC о нейронных сетях мы рассмотрели многие аспекты проектирования и обучения многослойных перцептронов. Прежде чем углубиться в локальные минимумы, просмотрите предыдущие статьи:
- Как выполнять классификацию с нейронной сетью: что такое перцептрон?
- Как использовать простой пример перцептрона для классификации данных
- Как обучать базовый перцептрон
- Понимание простого обучения нейронных сетей
- Введение в теорию обучения для нейронных сетей
- Понимание скорости обучения в нейронных сетях
- Продвинутое машинное обучение с многослойным перцептроном
- Сигмоидная функция активации: активация в многослойных перцептронах
- Как обучать многослойный перцептрон
- Понимание формул обучения и обратного распространения для многослойных перцептронов
- Архитектура нейронной сети для Python-реализации
- Как создать многослойный перцептрон на Python
- Обработка сигналов с нейронными сетями: валидация в дизайне нейронных сетей
- Обучающие наборы данных для нейронных сетей: как обучать и валидировать Python нейронную сеть
- Сколько скрытых слоёв и узлов нужно нейронной сети?
- Как повысить точность нейронной сети со скрытым слоем
- Включение узлов смещения в вашу нейронную сеть
- Понимание локальных минимумов в обучении нейронных сетей
Обучение нейронной сети — сложная оптимизационная задача. Хотя нам редко нужно понимать каждый математический нюанс для построения эффективных моделей, феномен локальных минимумов остаётся важным теоретическим соображением.
Почему локальные минимумы важны
Исторически локальные минимумы считались главным препятствием к обучению, особенно для сложных входно-выходных отображений. Недавние исследования — такие как работы по геометрии поверхностей потерь (Choromanska et al., 2015; Dauphin et al., 2014) — подсказывают, что современные архитектуры и эвристики обучения снижают серьёзность этой проблемы. Тем не менее, понимание локальных минимумов помогает оценить, как градиентные оптимизаторы навигируют по высокоразмерным ландшафтам потерь и почему определённые стратегии обучения могут выбираться из субоптимальных точек.
Определение локального минимума
Рассмотрим простую квадратичную поверхность ошибки: f(x, y) = x² + y². Любая точка, дающая наименьшую возможную ошибку — называемая глобальным минимумом — является целью обучения. В идеально выпуклой «чаше» градиентный спуск всегда сходится к этой точке независимо от стартовой позиции.
На практике поверхности потерь далеки от выпуклости. Они могут содержать множественные долины и плато, как показано ниже:
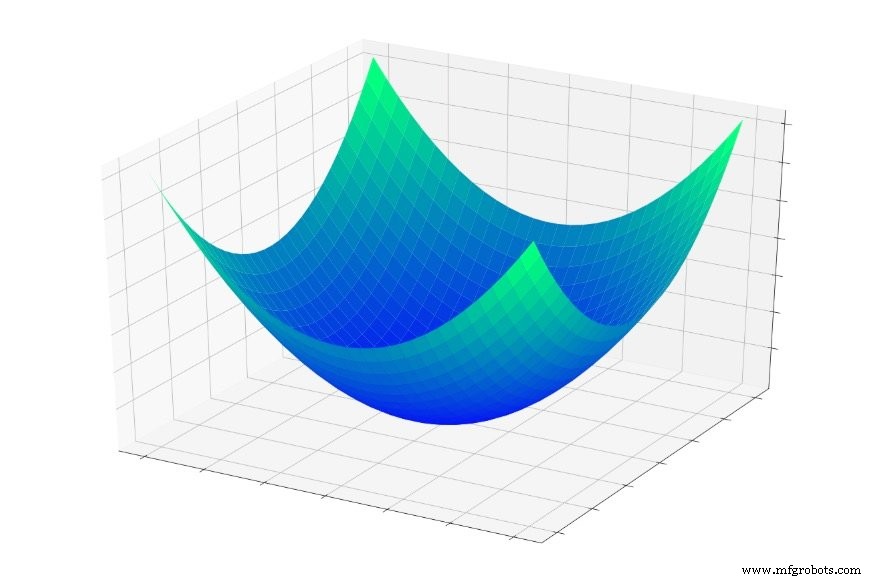
Когда оптимизатор попадает в мелкую впадину, он может застрять в локальном минимуме — наименьшей точке в этом локальном регионе — но не в глобальном. Без глобального знания алгоритм не может «подняться» обратно, чтобы исследовать более глубокие долины.
Нужен ли нам действительно глобальный минимум?
Хотя достижение глобального минимума часто коррелирует с меньшей обучающей ошибкой, это не всегда равносильно лучшей обобщающей способности. Высокоэкспрессивные сети, достигающие идеального подгонки на обучающих данных, могут переобучиться, снижая производительность на невидимых выборках. В таких случаях хорошо расположенный локальный минимум может дать более робастное решение. Кроме того, седловые точки — плоские области, где градиенты исчезают в некоторых направлениях — могут представлять больший вызов, чем простые локальные минимумы (Goodfellow et al., 2015).
Практические импликации
Современные практики обучения смягчают эффекты локальных минимумов через техники вроде стохастического градиентного спуска, расписаний скорости обучения, импульса, оптимизатора Adam и схем инициализации весов. Ансамблевые методы и регуляризация (dropout, L2) также помогают модели избегать переобучения к глобальному минимуму.
Заключение
Локальные минимумы остаются захватывающим аспектом обучения нейронных сетей. Понимание их влияния информирует выбор архитектуры, оптимизатора и стратегии регуляризации. В следующей статье мы изучим конкретные техники — такие как отжиг скорости обучения и адаптивные оптимизаторы — которые направляют сети к желаемым минимумам.
Промышленный робот
- Понимание сетевых топологий: от точки-точка к кольцу и звезде
- Понимание сетевых протоколов: от физического уровня к продвинутому арбитражу
- STMicroelectronics запускает STM32Cube.AI — внедрение нейросетей в пограничные устройства на STM32
- CEVA представляет NeuPro‑S:.next‑gen AI процессор для edge‑выводов глубоких нейросетей
- Добавление узлов смещения в многослойный перцептрон на Python
- Оптимизация размера скрытого слоя для повышения точности нейронной сети
- Искусственные нейронные сети повышают производительность беспроводной связи
- Обучение большой нейросети выделяет 284 000 кг CO₂ — эквивалент выбросов 5 автомобилей за жизнь
- Роботизированная резка волоконным лазером против плазменной резки: ключевые различия и выбор решения
- Нейросеть NIST обнаруживает крошечные геометрические фигуры в плотных изображениях с точностью 97%