



Оптимизация размера скрытого слоя для повышения точности нейронной сети
В этой статье мы проведём классификационные эксперименты и проанализируем, как размерность скрытого слоя влияет на производительность нейронной сети.
Узнайте, как настройка скрытого слоя в перцептроне может улучшить точность, сократить время обучения и сохранить приемлемую латентность — всё продемонстрировано с Python-реализацией и реальными датасетами.
Прежде чем погрузиться, ознакомьтесь с предыдущими постами нашей серии о нейронных сетях для построения твёрдой базы:
- Как выполнять классификацию с нейронной сетью: что такое перцептрон?
- Как использовать простой пример перцептрона для классификации данных
- Как обучать базовый перцептрон
- Понимание простого обучения нейронных сетей
- Введение в теорию обучения для нейронных сетей
- Понимание скорости обучения в нейронных сетях
- Продвинутое машинное обучение с многослойным перцептроном
- Сигмоидная функция активации: активация в многослойных перцептронах
- Как обучать многослойный перцептрон
- Понимание формул обучения и обратного распространения для многослойных перцептронов
- Архитектура нейронной сети для Python-реализации
- Как создать многослойный перцептрон на Python
- Обработка сигналов с нейронными сетями: валидация в дизайне нейронных сетей
- Обучающие наборы данных для нейронных сетей: как обучать и валидировать Python нейронную сеть
- Сколько скрытых слоёв и узлов нужно нейронной сети?
- Как повысить точность нейронной сети со скрытым слоем
Число узлов в скрытом слое напрямую влияет на точность классификации и скорость обучения. Наши эксперименты дадут данные-ориентированную интуицию для выбора размера скрытого слоя, балансирующего скорость, латентность и точность.
Бенчмаркинг в Python
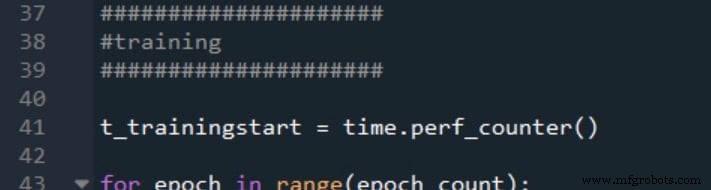
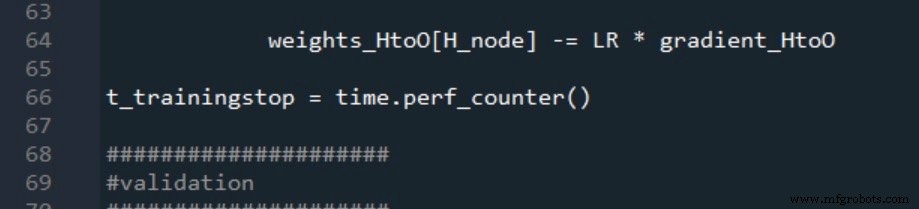
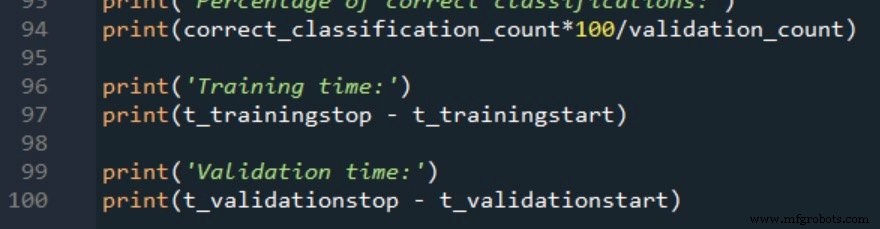
Мы дополним существующий Python-код из части 12 для записи длительностей обучения и валидации с использованием time.perf_counter(). Ниже инструментирование тайминга:
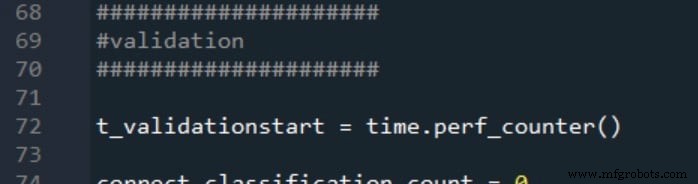
Тайминг валидации следует тому же паттерну:
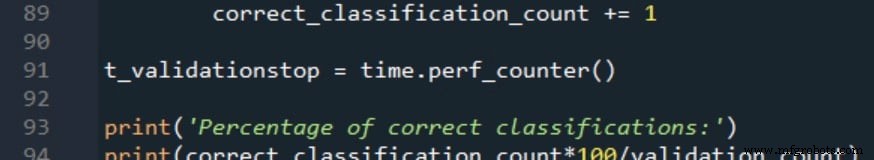
Результаты отчитываются как:
Обучающие данные и процедура измерения
Мы тестируем задачу бинарной классификации с четырьмя числовыми входами в диапазоне –20 … +20. Архитектура сети: 4 входных узла, один скрытый слой, один выходной узел. Входные значения генерируются Excel-формулой, показанной ниже:
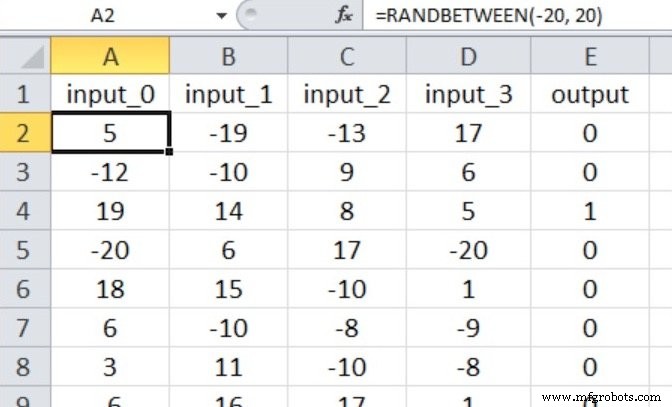
Размеры датасетов: 40 000 обучающих и 5 000 валидационных сэмплов. Используем скорость обучения 0,1 и одну полную эпоху на запуск. Каждая размерность скрытого слоя тестируется пять раз; отчитываемые точность и тайминг — арифметические средние.
Эксперимент 1: Низкосложная задача
Цель истинна только когда первые три входа превышают ноль; четвёртый вход неважен:
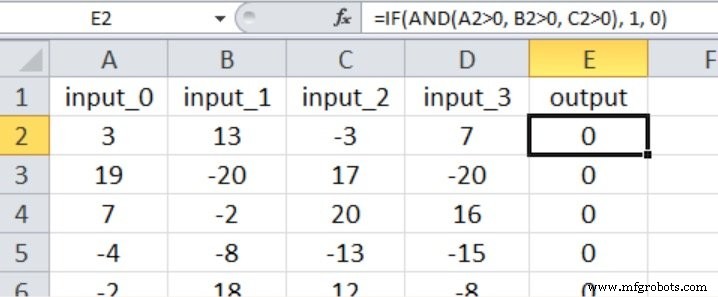
Следуя эвристике двух третей от размера входа, начинаем с H_dim = 2. Результаты суммированы ниже:
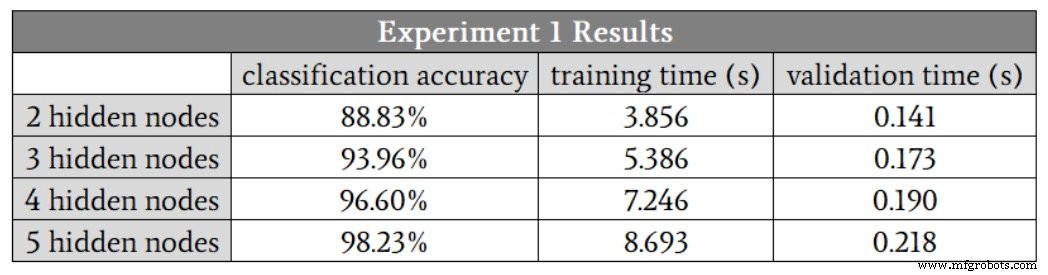
Точность улучшается до пяти скрытых узлов, но предельный выигрыш от четырёх до пяти узлов незначителен, потому что один запуск с четырьмя узлами был выбросом (88,6%). Удаление выброса показывает, что четыре узла слегка превосходят пять. Время обучения растёт в 1,9 раза от двух до четырёх узлов, в то время как время валидации увеличивается лишь в 1,3 раза, подчёркивая, что обучение — более вычислительно интенсивная фаза.
Эксперимент 2: Средне-сложная задача
Все четыре входа влияют на выход с более нюансированными сравнениями:
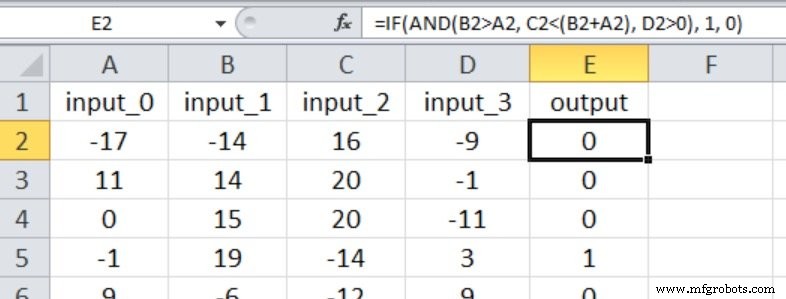
Начиная с трёх скрытых узлов, результаты:
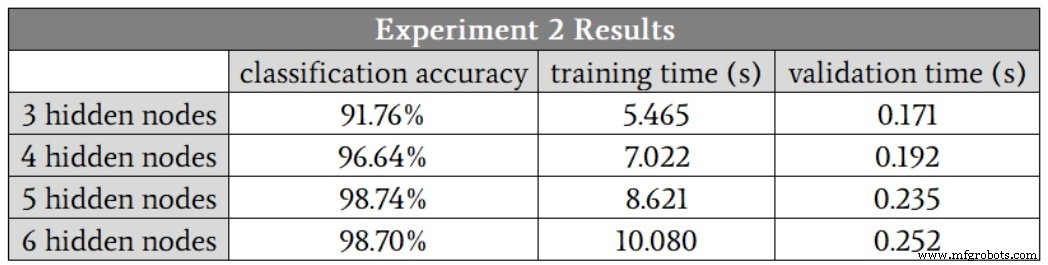
Здесь пять скрытых узлов кажутся оптимальными, балансируя точность и скорость. В отличие от Эксперимента 1, запуски с пятью и шестью узлами не показывают выбросов с низкой точностью, предполагая, что более крупные скрытые слои дают робастность против дисперсии обучения.
Эксперимент 3: Высоко-сложная задача
Этот сценарий вводит нелинейность: один вход возводится в квадрат, другой — извлекается квадратный корень:
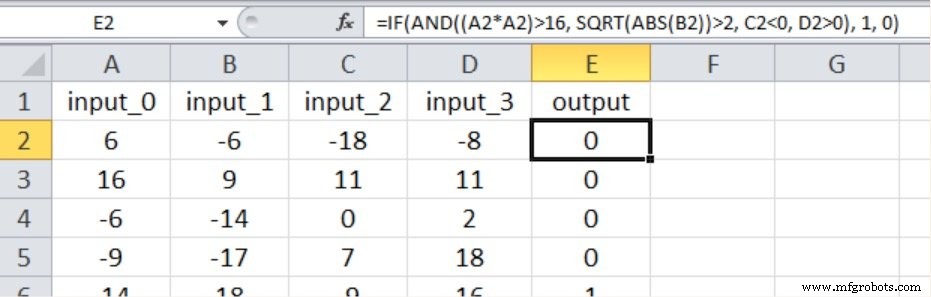
Результаты:
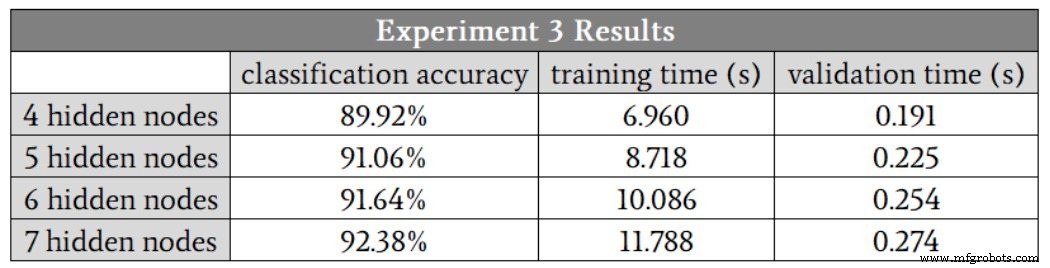
Точность падает по сравнению с низко-сложными задачами, даже с семью скрытыми узлами. Улучшения вроде добавления смещения или отжига скорости обучения могли бы улучшить производительность, но до валидации таких изменений рекомендуется семиузловый скрытый слой.
Заключение
Эти эксперименты иллюстрируют чёткий компромисс: увеличение размерности скрытого слоя обычно повышает точность и стабильность, но ценой более длительного обучения. Используйте данные-ориентированные инсайты здесь для информирования ваших дизайнерских решений при построении перцептрон-базированных классификаторов.
Промышленный робот
- Выбор правильного числа скрытых слоёв и узлов в нейронной сети
- Обучение нейронных сетей с Excel: построение и валидация Python многослойного перцептрона
- Построение многослойного перцептрона на Python: практическое руководство
- Проектирование гибкого перцептрона на Python: архитектура, смещение и активация
- Обучение многослойного перцептрона: проверенные стратегии для оптимальной производительности
- Как подключённые сети революционизируют современное земледелие
- Безопасность IoT от железа до приложения: пошаговый план по слоям
- Thomas WebTrax vs Google Analytics и Thomas Network: какой инструмент движет ваши промышленные лиды?
- Как датчики сети 0G защищают холодильные цепи вакцин
- Выбор идеальной лазерной резальной системы: продуктивность и точность