



Обучение многослойного перцептрона: проверенные стратегии для оптимальной производительности
Мы можем значительно улучшить производительность перцептрона, добавив слой скрытых узлов, но эти скрытые узлы также делают обучение немного более сложным.
До сих пор в серии AAC о нейронных сетях вы узнали о классификации данных с помощью нейронных сетей, особенно перцептронного типа.
Догните серию ниже или погрузитесь в эту новую запись, которая объяснит основы многослойного перцептрона (MLP) нейронной сети.
- Как выполнять классификацию с нейронной сетью: что такое перцептрон?
- Как использовать простой пример перцептрона для классификации данных
- Как обучать базовый перцептрон
- Понимание простого обучения нейронных сетей
- Введение в теорию обучения для нейронных сетей
- Понимание скорости обучения в нейронных сетях
- Продвинутое машинное обучение с многослойным перцептроном
- Сигмоидная функция активации: активация в многослойных перцептронах
- Как обучать многослойный перцептрон
- Понимание формул обучения и обратного распространения для многослойных перцептронов
- Архитектура нейронной сети для Python-реализации
- Как создать многослойный перцептрон на Python
- Обработка сигналов с нейронными сетями: валидация в дизайне нейронных сетей
- Обучающие наборы данных для нейронных сетей: как обучать и валидировать Python нейронную сеть
Что такое многослойный перцептрон?
Предыдущая статья показала, что однослойный перцептрон просто не может производить тот уровень производительности, который мы ожидаем от современной нейронно-сетевой архитектуры. Система, ограниченная линейно разделимыми функциями, не сможет аппроксимировать сложные вход-выход отношения, возникающие в реальных сценариях обработки сигналов. Решение — многослойный перцептрон (MLP), такой как этот:
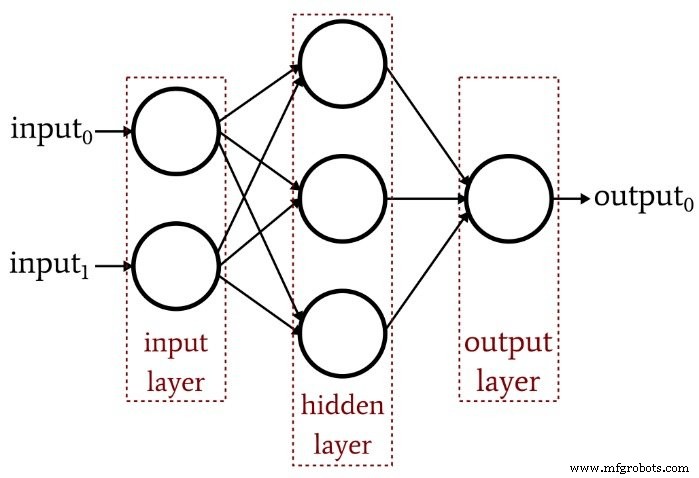
Добавляя этот скрытый слой, мы превращаем сеть в «универсальный аппроксиматор», который может достигать экстремально сложной классификации. Но мы всегда должны помнить, что ценность нейронной сети полностью зависит от качества её обучения. Без обильных, разнообразных обучающих данных и эффективной процедуры обучения сеть никогда не «научится» классифицировать входные сэмплы.
Почему скрытый слой усложняет обучение?
Посмотрим на правило обучения, которое мы использовали для обучения однослойного перцептрона в предыдущей статье:
\[w_{new} = w+(\alpha\times(output_{expected}-output_{calculated})\times input)\]
Обратите внимание на неявное предположение в этом уравнении: мы обновляем веса на основе наблюдаемого выхода, поэтому для этого веса однослойного перцептрона должны напрямую влиять на выходное значение. Это как выбор температуры воды из крана поворотом двух ручек для горчей и холодной воды. Отношение между общей температурой и действием ручек довольно прямолинейно, и даже люди, не любящие математику, могут найти желаемую температуру воды, покрутив ручками немного.
Но теперь представьте, что поток воды через горячие и холодные трубы связан с положением ручек сложным, высоко нелинейным образом. Вы плавно и медленно поворачиваете ручку горячей воды, но результирующий расход меняется непредсказуемо. Пробуете ручку холодной воды — то же самое. Установка идеальной температуры воды при этих условиях — особенно поскольку «выход» должен быть достигнут комбинацией двух запутанных контрольных отношений — было бы гораздо сложнее.
Так я понимаю дилемму скрытого слоя. Веса, соединяющие входные узлы со скрытыми узлами, концептуально аналогичны этим механически нестабильным ручкам — потому что вход-скрытые веса не имеют прямого пути к выходному слою, отношение между этими весами и выходом сети настолько сложно, что простое правило обучения, показанное выше, не будет эффективным.
Новая парадигма обучения
Поскольку оригинальное правило обучения перцептрона не может быть применено к многослойным сетям, нам нужно переосмыслить нашу обучающую стратегию. Что мы сделаем — включим градиентный спуск и минимизацию функции ошибки.
Одна вещь, которую нужно иметь в виду: эта процедура обучения не специфична для многослойных нейронных сетей. Градиентный спуск приходит из общей теории оптимизации, и процедура обучения, которую мы используем для MLP, также применима к однослойным сетям. Однако, насколько я понимаю, MLP-стиль градиентного спуска (по крайней мере теоретически) избыточен для однослойного перцептрона, потому что более простое правило, показанное выше, в конечном счёте сделает работу.
Вывод фактических уравнений обновления весов для MLP включает некоторую завораживающую математику, которую я не буду пытаться интеллектуально объяснить в этот момент. Моя цель для остатка этой статьи — дать концептуальное введение в два ключевых аспекта обучения MLP — градиентный спуск и функцию ошибки — и затем продолжим это обсуждение в следующей статье, включив новую функцию активации.
Градиентный спуск
Как подразумевает название, градиентный спуск — это средство спуска к минимуму функции ошибки на основе наклона. Диаграмма ниже передаёт способ, которым градиент даёт нам информацию о том, как модифицировать веса — наклон точки на функции ошибки говорит нам, в каком направлении нам нужно идти и насколько далеко мы от минимума.
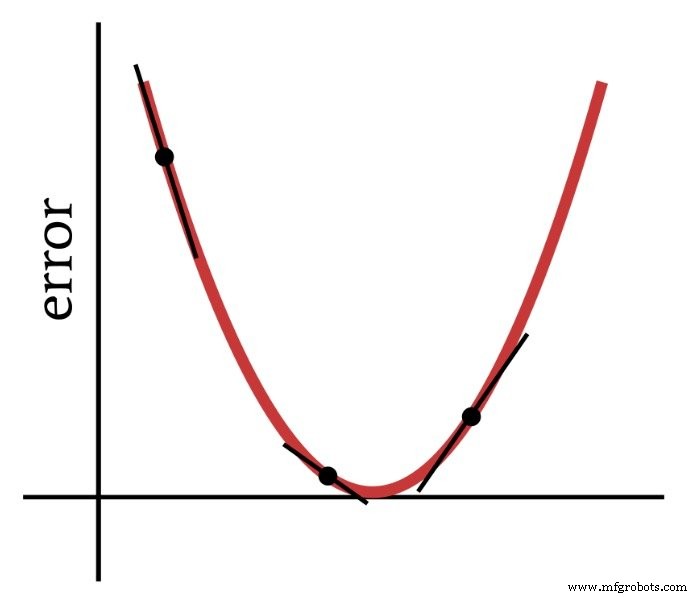
Таким образом, производная функции ошибки — важный элемент вычислений, которые мы используем для обучения многослойного перцептрона. На самом деле, нам понадобятся частные производные. Когда мы реализуем градиентный спуск, мы делаем каждую модификацию веса пропорциональной наклону функции ошибки относительно модифицируемого веса.
Функция ошибки (также известная как функция потерь)
Частый метод количественной оценки ошибки нейронной сети — возвести в квадрат разницу между ожидаемым (или «целевым») значением и вычисленным значением для каждого выходного узла, а затем сложить все эти квадратичные разницы. Это можно назвать «суммой квадратичных разниц» или «суммарной квадратичной ошибкой» или разными другими вещами, и вы также увидите аббревиатуру LMS, означающую least-mean-square, потому что цель обучения — минимизировать среднеквадратичную ошибку. Эта функция ошибки (обозначаемая E) может быть математически выражена так:
\[E=\frac{1}{2}\sum_k(t_k-o_k)^2\]
где k указывает диапазон выходных узлов, t — целевое выходное значение, а o — вычисленное выходное значение.
Заключение
Мы заложили основу для успешного обучения многослойного перцептрона, и продолжим исследовать эту интересную тему в следующей статье.
Промышленный робот
- Понимание сетевых топологий: от точки-точка к кольцу и звезде
- Как стать автоэлектриком: обучение, обязанности и карьерные перспективы
- Укрепление промышленных IoT устройств для предотвращения кибератак
- CEVA представляет NeuPro‑S:.next‑gen AI процессор для edge‑выводов глубоких нейросетей
- Как подключённые сети революционизируют современное земледелие
- Как интеллектуальные сети движут бизнес-эффективность и рост
- Узнайте свой ключ безопасности сети: простые шаги для поиска и защиты Wi‑Fi
- Искусственные нейронные сети повышают производительность беспроводной связи
- Оценка безопасности сети цеха: готовы ли вы?
- Подготовка рабочей силы завтрашнего дня к Industry 4.0: стратегии обучения для цифровой фабрики