



Добавление узлов смещения в многослойный перцептрон на Python
В этой статье объясняется, как включить узлы смещения (bias) в многослойный перцептрон (MLP) на Python, и оценивается их влияние на классификационную производительность.
Добро пожаловать в серию AAC о нейронных сетях, автором которой является директор по инженерии Роберт Кейм. Если вы ещё не изучили остальные уроки, найдите их ниже. Они дают твёрдую базу для понимания концепций, обсуждаемых в этом посте.
- Как выполнять классификацию с нейронной сетью: что такое перцептрон?
- Как использовать простой пример перцептрона для классификации данных
- Как обучать базовый перцептрон
- Понимание простого обучения нейронных сетей
- Введение в теорию обучения для нейронных сетей
- Понимание скорости обучения в нейронных сетях
- Продвинутое машинное обучение с многослойным перцептроном
- Сигмоидная функция активации: активация в многослойных перцептронах
- Как обучать многослойный перцептрон
- Понимание формул обучения и обратного распространения для многослойных перцептронов
- Архитектура нейронной сети для Python-реализации
- Как создать многослойный перцептрон на Python
- Обработка сигналов с нейронными сетями: валидация в дизайне нейронных сетей
- Обучающие наборы данных для нейронных сетей: как обучать и валидировать Python нейронную сеть
- Сколько скрытых слоёв и узлов нужно нейронной сети?
- Как повысить точность нейронной сети со скрытым слоем
- Включение узлов смещения в вашу нейронную сеть
Узлы смещения — дополнительные входы, подающие постоянное значение (обычно +1) непосредственно на входной или скрытый слой перцептрона. Они позволяют сети сдвигать границы решения без изменения самих входных данных. Эта статья представляет два практических метода добавления узлов смещения и показывает, как оценить их влияние на точность модели.
Метод 1: Добавление смещения через таблицу
Когда ваши обучающие или валидационные данные находятся в таблице, вы можете вставить колонку смещения без изменения Python-кода.
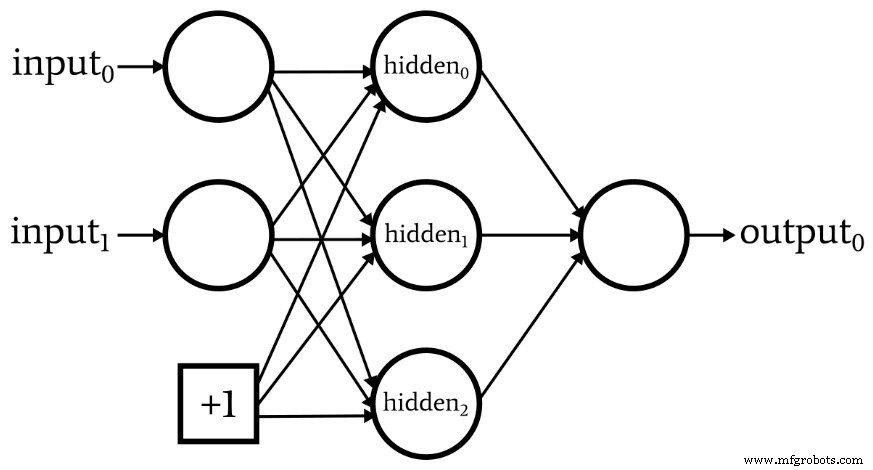
Шаги:
- Вставьте новый столбец в таблицу и заполните его желаемым значением смещения (обычно +1).
- Скорректируйте размерность входного слоя в коде для учёта нового столбца.
Этот подход быстр и не требует изменений кода, идеально для прототипирования.
Метод 2: Интеграция смещения прямо в Python
Для большей гибкости — например, добавления смещения к скрытым слоям — вы модифицируете архитектуру сети в коде. Ниже приведён краткий пример, добавляющий узлы смещения к входному и скрытому слоям.
Обновление размерности входного слоя
# Загрузка обучающих данных
training_data = np.array(...) # shape: (samples, features)
training_count = training_data.shape[0]
# Добавление столбца единиц для входного смещения
bias_column = np.ones((training_count, 1))
training_data = np.hstack((training_data, bias_column))
# То же для валидационных данных
validation_data = np.hstack((validation_data, np.ones((validation_count, 1))))
Здесь np.ones создаёт столбец единиц, представляющий постоянный вход смещения. Функция np.hstack затем присоединяет этот столбец к существующей матрице признаков.
Добавление узла смещения в скрытый слой
# Во время прямого прохода для каждого узла скрытого слоя
for node in range(hidden_dim):
    # Вычисление взвешенной суммы для каждого скрытого узла
    z = np.dot(input_vector, weights_input_hidden[:, node])
    post_activation[node] = activation_function(z)
# Вставка значения узла смещения (+1) в скрытый слой
post_activation[hidden_dim] = 1.0 # Узел смещения в конце
Когда hidden_dim включает узел смещения, цикл останавливается перед последним узлом, и значение смещения присваивается после. Аналогично корректируется валидационный цикл.
Выбор других значений смещения
Хотя +1 — конвенция, вы можете экспериментировать с другими константами. Для входного смещения умножьте bias_column на желаемое значение. Для скрытого смещения измените присваивание в цикле прямого прохода соответственно.
Оценка влияния смещения
В части 16 серии MLP боролся с классификацией высокосложного датасета Experiment 3. Чтобы определить, могут ли узлы смещения помочь, мы выполнили десять независимых обучающих запусков со скрытым слоем из семи единиц, сравнивая четыре конфигурации: без смещения, только входное смещение, только скрытое смещение и оба смещения.
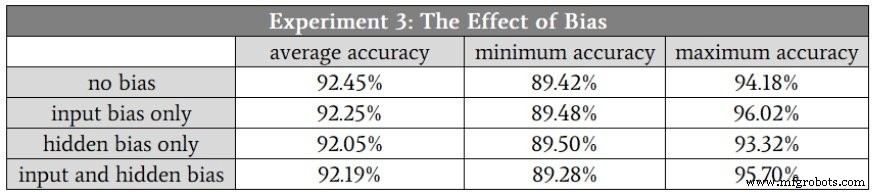
Результаты показывают минимальные различия — узлы смещения незначительно улучшили точность для этого конкретного датасета. Этот результат согласуется с выводами других исследований, что узлы смещения могут быть полезны в определённых контекстах, но не являются универсальным ускорителем производительности.
Заключение
Хотя узлы смещения редко трансформируют точность классификации во всех сценариях, они остаются ценным архитектурным инструментом. Включение поддержки смещения в вашу кодовую базу гарантирует, что вы сможете быстро протестировать его эффективность на будущих датасетах или вариантах модели. Следуя описанным методам, вы можете добавлять узлы смещения с минимальными усилием и систематически оценивать их влияние.
Промышленный робот
- Пересмотр мониторинга сети: Стратегический плейбук для современной корпоративной ИТ
- Укрепление промышленных IoT устройств для предотвращения кибератак
- Построение доступной беспроводной сети датчиков для дома
- Локальные минимумы в обучении нейронных сетей: миф или реальность?
- Оптимизация размера скрытого слоя для повышения точности нейронной сети
- Интеграция управления запасными частями в CMMS: повысьте эффективность и снизьте затраты
- Выбор правильной IoT-сети: инсайты от экспертов отрасли
- Интеграция роботов: проверенные стратегии успеха для производственных объектов
- Превратите сбои цепочки поставок в стратегические возможности
- Оценка безопасности сети цеха: готовы ли вы?