



Интеграция domain-specific акселераторов в RISC-V для AI, AR/VR и vision нагрузок
Когда RISC-V экосистема только появлялась, первичный фокус — снижение затрат в deeply embedded системах, ранее полагавшихся на проприетарные CPU ISA. По мере миграции SoC на FinFET процессы, высокие mask costs заставили многих дизайнеров заменить конечные автоматы на программируемые микросеквенсоры на базе RISC-V ISA. Этот сдвиг спровоцировал начальный энтузиазм и, с 2014 по 2018 г., привёл к коммодитизации лёгких RISC-V ядер.
По мере зрелости архитектуры, RISC-V набрала traction в real-time, high-performance приложениях — особенно как front end к высокоспециализированным acceleration engines для AI, AR/VR и computer vision. Открытая природа RISC-V позволяет дизайнерам расширять ISA, позволяя процессорам коммуницировать с акселераторами через low-latency co-processor интерфейсы вместо традиционного memory-mapped I/O.
RISC-V vector extension дополнило усилило эти акселераторы для обработки промежуточных слоёв внутри kernel inner loops. Однако этого требовало purpose-built расширений, таких как кастомная load инструкция, пересылающая данные из внешнего акселератора во внутренние векторные регистры.
Эти приложения требуют программную модель, балансирующую эффективность с гибкостью. Domain-specific акселератор — по сути большой массив множителей — высокоэффективен, но ограничен в операциях и data-movement capabilities. Напротив, general-purpose CPU вроде x86 даёт максимум гибкости, но большинство дизайнов не могут позволить >100 Вт power budget для такой универсальности.
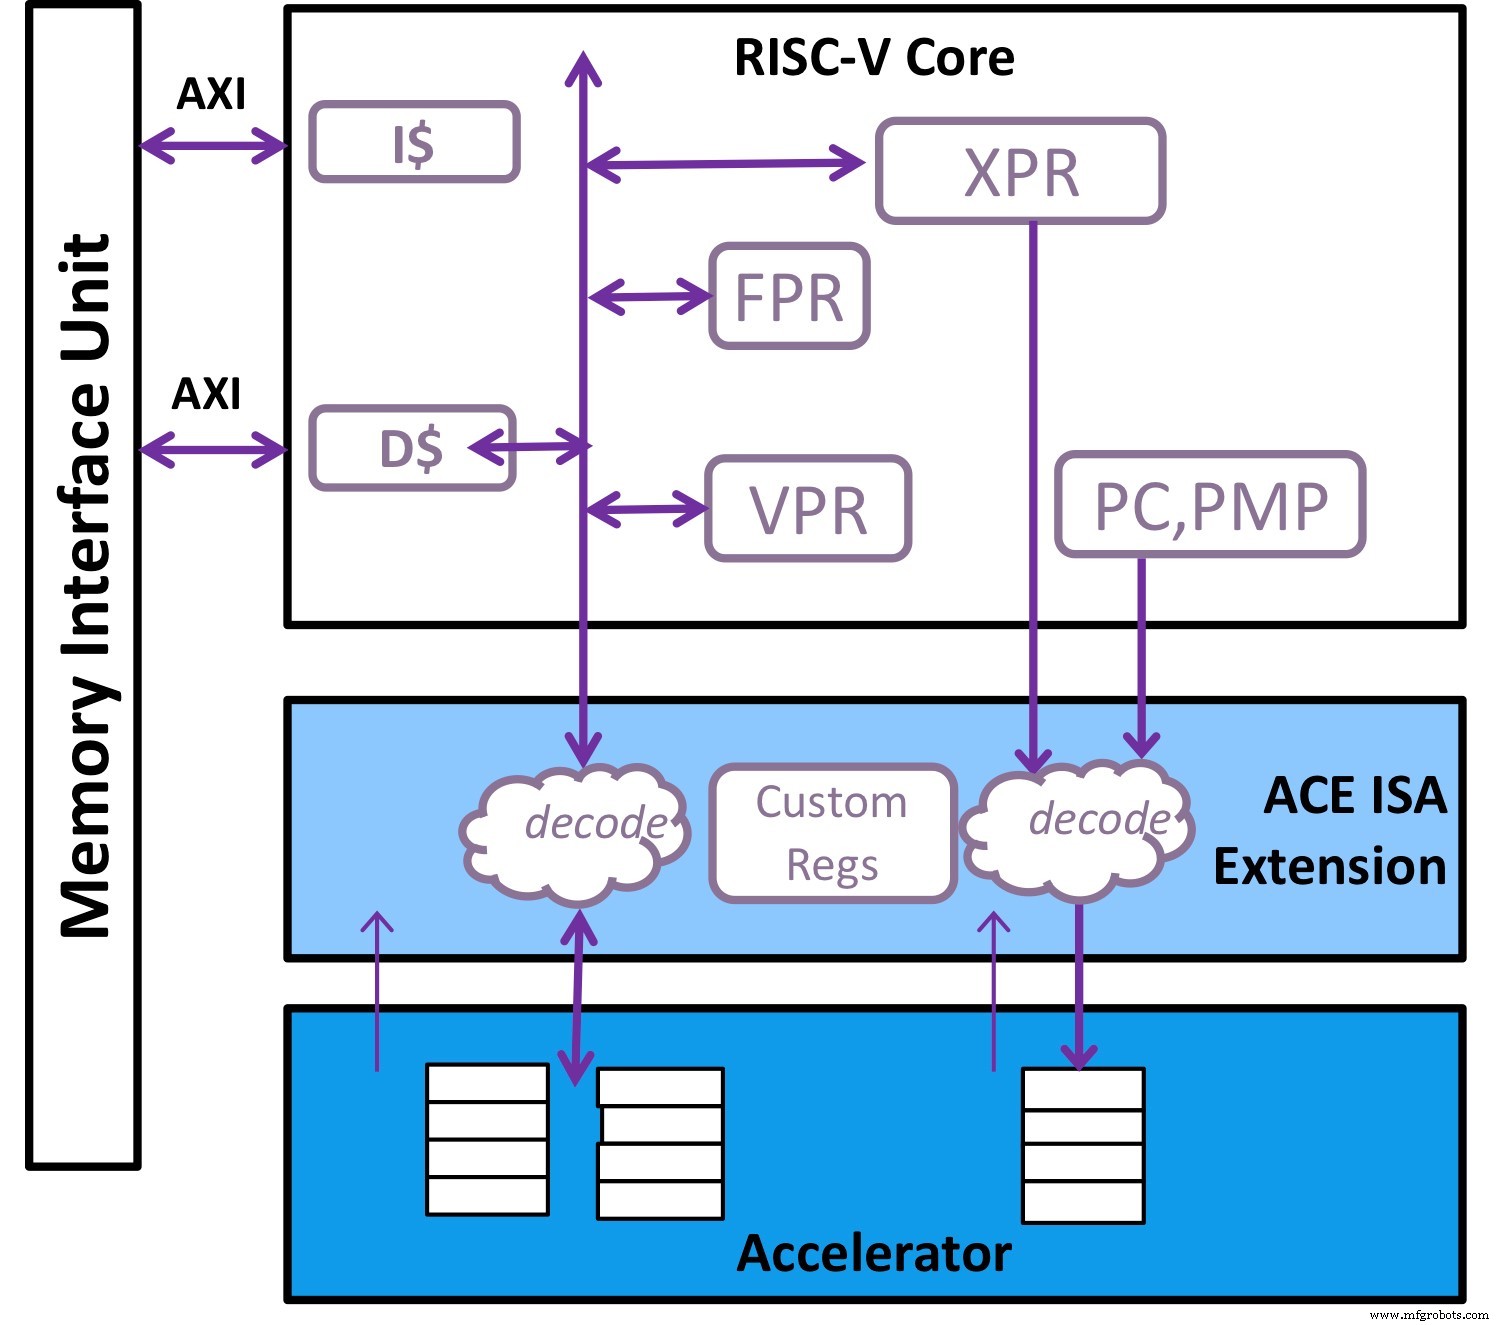
Оптимальное решение смешивает гибкость general-purpose CPU с task-specific акселератором, как проиллюстрировано выше. В RISC-V зрелое стандартное векторное расширение — augmented с tailored кастомными инструкциями — служит идеальным партнёром. Эта синергия стала очевидна за последние 18 месяцев, когда domain-specific acceleration (DSA) решения конвергировали на RISC-V платформы.
Для реализации этой визии акселератор должен запускать свой command set, используя dedicated ресурсы, включая память. RISC-V ядро должно flatten микрокод, упаковывая всю необходимую контрольную информацию в единственную команду. Этот command set должен быть aware процессорных scalar и vector регистров, а также control регистров и памяти акселератора.
Когда акселератору нужна помощь со специализированным data reordering или manipulation, Andes архитектура использует vector processing unit (VPU) для handle сложных перестановок — shifting, gathering, compressing, expanding. Между слоями kernels часто включают intricate data patterns; VPU поставляет нужную гибкость. С обоими — акселератором и VPU — исполняющими massively parallel вычисления, Andes ввёл железо для поднятия memory subsystem bandwidth — prefetching, non-blocking transactions, out-of-order returns — для встречи computational demand.
Первый RISC-V векторный процессор Andes Technology, NX27V, имплементирует последнюю V-extension 0.8 спецификацию. Поддерживает 8-, 16-, 32-бит integer операции, 16- и 32-бит floating-point, Bfloat16 и Int4 форматы для снижения storage и transfer bandwidth для ML weights. Гибкость векторной спеки позволяет дизайнерам конфигурировать ключевые параметры — vector length, bits per register, SIMD width, bits processed per cycle.
NX27V предлагает 512-битную vector length, расширяемую до 4096 бит цепочкой до восьми векторных регистров. Множественные functional units операют в параллельных пайплайнах, sustain throughput для diverse workloads. В 512-битной конфигурации чип достигает 1 ГГц в 7 нм процессе под worst-case условиями, занимая всего 0.3 мм². Для софт-девелопмента Andes поставляет компилятор, дебаггер, векторные библиотеки, cycle simulator и Clarity visualization tool для анализа и оптимизации критических loops. Решение уже доступно через early-access программу.
За последние 15 месяцев спрос на high-performance computing — комбинирующее мощное RISC-V векторное расширение, high-bandwidth memory subsystem и акселератор близко к CPU — взлетел. Этот тренд готов драйвить broader adoption RISC-V и векторной обработки по всей индустрии.
>> Эта статья изначально опубликована на нашем партнёрском сайте EE Times.
Встроенный
- IIC и OpenFog объединяются для лидерства в распределенных вычислениях для промышленного IoT
- Выпущена Industrial Internet Reference Architecture v1.8: представлен паттерн многослойной шины данных
- Использование IoT для раннего обнаружения и предотвращения лесных пожаров
- Подключение удаленного мира: как сателлитный IoT расширяет глобальное покрытие
- Ускорьте приложения с адаптированными пользовательскими инструкциями RISC-V
- Собственное производство: Fuse 1 печатает свои собственные детали
- Использование данных в Интернете надежности: стратегии эффективного управления
- Периферийные вычисления: Архитектура, движущая интеллектуальными сетями завтрашнего дня
- Защита вашей IoT-экосистемы: экспертные стратегии против ransomware и киберугроз
- IoT революционизирует полевой сервис: предиктивное обслуживание и выше ROI