



Облачное аварийное восстановление: 9 ключевых преимуществ для вашего бизнеса
Данные вашего бизнеса постоянно находятся под угрозой атак или потери.
Вредоносное ПО, хакеры, стихийные бедствия и даже ваши сотрудники могут в любой момент уничтожить целый сервер с критически важными файлами, и никто не заметит этого, пока не станет слишком поздно.
Готовы ли вы принять все эти риски?
Что такое облачное аварийное восстановление?
Облачные решения для хранения и восстановления позволяют создавать резервные копии и восстанавливать критически важные файлы бизнеса в случае их компрометации.
Благодаря высокой гибкости облачные технологии обеспечивают эффективное аварийное восстановление независимо от типа или интенсивности рабочих нагрузок. Данные хранятся в защищенной облачной среде, спроектированной для обеспечения высокой доступности. Сервис предоставляется по запросу, что позволяет организациям любого масштаба адаптировать решения DR под свои нужды.
В отличие от традиционных решений, облачное аварийное восстановление легко настраивать и управлять. Бизнесу больше не нужно тратить часы на перенос резервных данных с локальных серверов или ленточных накопителей для восстановления после сбоя. Облако автоматизирует эти процессы, гарантируя быстрое и безошибочное восстановление данных.
Всегда будьте готовы с надлежащей защитой данных
По мере того как компании внедряют новое оборудование, программное обеспечение и сервисы в свои ежедневные процессы, связанные риски безопасности растут. Катастрофы могут произойти в любой момент и нанести бизнесу ущерб в виде массовой потери данных. Учитывая их потенциальную стоимость, становится понятно, почему имеет смысл создавать план резервного копирования и восстановления данных.
Статистика аварийного восстановления показывает, что 98% опрошенных организаций указывают, что даже один час простоя может стоить бизнесу более $100 000. Любой объем простоя может обойтись компании в десятки или сотни тысяч долларов на трудозатраты для восстановления или повторной выполнения потерянной работы. В некоторых случаях 8-часовое окно простоя может стоить малой компании до $20 000, а крупным предприятиям — десятки тысяч долларов.
Учитывая эти цифры, становится очевидно, почему каждая секунда прерывания сервиса или системы имеет значение и какова реальная ценность наличия плана аварийного восстановления.
Облачное восстановление помогает бизнесу восстанавливаться после стихийных бедствий, кибератак, программ-вымогателей и других угроз, которые могут мгновенно сделать все файлы бесполезными. Просто за счет минимизации времени, необходимого для возврата рабочих нагрузок в онлайн, оно напрямую снижает стоимость системного сбоя.
Хотя большинство компаний и их IT-отделы осознают риски, القليل из них прилагают усилия для внедрения аварийного восстановления до тех пор, пока не станет слишком поздно. Теперь давайте подробнее рассмотрим, как это переводится в бизнес-преимущества.
Преимущества облачного решения для аварийного восстановления
Одним из самых значительных преимуществ облачных вариантов перед стандартным управлением аварийным восстановлением является их стоимостная эффективность. Традиционное резервное копирование предполагает развертывание физических серверов в удаленном месте, что может быть дорого. Облако же позволяет аутсорсить столько аппаратных и программных ресурсов, сколько необходимо, платя только за фактическое использование.
Рассчитывая стоимость аварийного восстановления, важно смотреть шире, чем только на цену самого решения.
Подумайте, сколько будет стоить его отсутствие. Малые компании могут выбрать тарифный план, соответствующий их бюджету. Внедрение управления данными не требует дополнительных затрат на обслуживание или найма IT-команд. Ваш провайдер берет на себя всю техническую работу, так что вам не о чем беспокоиться.
Еще одно преимущество облачных технологий — их надежность. Провайдеры услуг располагают центрами обработки данных для обеспечения избыточности, что гарантирует максимальную доступность ваших данных. Это также позволяет восстанавливать резервные копии быстрее, чем при традиционном DR.
Миграция рабочих нагрузок и переключение (failover) в облачных средах может занимать всего несколько минут. С традиционными решениями восстановления этот временной интервал обычно больше, так как переключение задействует физические серверы, развернутые в удаленном месте. В зависимости от объема данных для резервного копирования, можно также выбрать поэтапную миграцию.
Облачные сервисы резервного копирования предлагают высокую степень масштабируемости. По сравнению с физическими системами, облачное резервное копирование практически неограничено. По мере роста организаций их системы могут расти вместе с ними. Все, что нужно — расширить тарифный план у провайдера и получить дополнительные ресурсы по мере необходимости.
Возможности переключения (failover) и возврата (failback) в облаке
Когда речь идет о критически важных для бизнеса данных, облачное резервное копирование и восстановление обеспечивают самый надежный вариант непрерывности бизнеса и возврата (failback).
Во время сбоя в доступе к данным рабочие нагрузки автоматически переносятся в другое место и перезапускаются оттуда. Этот процесс называется failover (переключение), и он инициируется, когда основные системы сталкиваются с проблемой. После устранения проблем в исходном месте рабочие нагрузки возвращаются (failback) обратно. Это делается с помощью профессиональных инструментов аварийного восстановления и репликации, доступных у провайдеров центров обработки данных и инфраструктуры как услуги (IaaS).
Хотя операции failover и failback могут быть автоматизированы в облаке, компаниям следует регулярно проводить тесты на выделенных сетевых участках, чтобы убедиться в отсутствии влияния на живые или производственные данные сети.
При формировании набора данных в решении для аварийного восстановления можно выбрать данные, образы виртуальных машин или полные приложения для переключения. Этот процесс может занять некоторое время, поэтому организации должны обсудить каждый его шаг с провайдером центра обработки данных.
Disaster Recovery as a Service (DRaaS) — Аварийное восстановление как услуга
Частью плана облачного аварийного восстановления может быть DRaaS. Он предназначен для помощи организациям в защите от потери критически важных бизнес-данных.
Эти решения требуют от бизнеса понимания того, что им нужно от сервиса.
Компания может определить общий пул данных, подлежащий резервному копированию, и частоту его выполнения. Кроме того, компании должны определить уровень усилий, необходимых для инвестирования в резервное копирование данных в процессе аварийного восстановления. После уточнения требований они могут поискать провайдеров DRaaS, соответствующих их нуждам.
Как развивается облачное резервное копирование и восстановление
По мере того как кибератаки и системные сбои становятся все более обыденными, компании все чаще обращаются к аварийному восстановлению в облаке.
По мере роста спроса провайдеры продолжают улучшать свои предложения. Недавние отчеты указывают, что рынок облачных сервисов резервного копирования и DR растет, с увеличивающимся количеством решений для компаний разного размера.
Рост спроса также демонстрирует более высокое осознание их ценности. Кибератаки и системные сбои происходят ежедневно, и бизнесу справедливо беспокоится о безопасности своих данных. Им нужен вариант, способный защитить данные в множестве сценариев, ставящих под угрозу ежедневные операции.
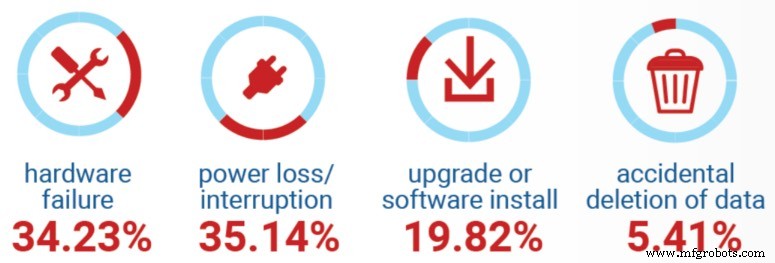
Исследования также показали, что основной причиной простоя является отключение электроэнергии. Это означает, что сколько бы копий файлов ни хранилось внутри компании, все они могут быть потеряны, если пропадет питание. С облачным DRaaS ваши данные сохраняются удаленно с надежными источниками питания. В большинстве случаев облачные сервисы распределяют данные по разным электрическим сетям, обеспечивая достаточную избыточность.
Многие старые сервисы включали физические резервные копии в удаленных местах. Внешнее резервное копирование дорого и неэффективно, так как требует дублирования физического оборудования в другом месте или комбинации локальных и физических бэкапов.
Соглашения об уровне сервиса (SLA) в облаке
Соглашения об уровне сервиса (SLA) делают провайдеров облачного аварийного восстановления ответственными за все обслуживание и управление предоставляемыми услугами. Они также включают детали о возможных мерах и штрафах за невыполнение обещанных сервисов.
Например, SLA может гарантировать, что провайдеры DR компенсируют клиентам сервисными кредитами в случае сбоя сервиса или если данные не могут быть восстановлены при катастрофе. Клиенты могут использовать эти кредиты для оплаты ежемесячного счета или других услуг провайдера DR, хотя эти кредиты не покроют полностью убытки бизнеса от задержки облачного восстановления.
SLA также включает гарантированное время работы, цели точки восстановления (RPO) и времени восстановления (RTO). Например, последнее может быть любым заданным временем от часа до 24 часов или более в зависимости от объема данных для резервного копирования и восстановления. Более конкретно, это определяется в терминах RTO и RPO — ключевых понятий аварийного восстановления.
Цель времени восстановления (RTO) — это допустимый период простоя приложений. Цели точки восстановления (RPO) — это допустимый период недоступности данных. Исходя из этих двух критериев, компании определяют свои потребности и могут выбрать адекватное решение.
Определите свои требования к восстановлению
Важной частью любого плана облачного резервного копирования и аварийного восстановления является объем пропускной способности и сетевой емкости, необходимый для выполнения переключения (failover).
Достаточный анализ того, как сделать данные доступными при необходимости, необходим для выбора лучшего варианта для компании. Частью рассмотрения должно быть то, может ли сеть и пропускная способность справиться с перенаправлением всех пользователей в облако одновременно.
Другое соображение для гибридных сред — как восстановить данные из облака в локальную сеть центра обработки данных и сколько времени это займет. Наборы резервных копий для восстановления также должны быть спроектированы как часть любого решения для аварийного восстановления.
При определении этих требований RTO и RPO играют главную роль. Обе эти цели включаются в анализ воздействия на бизнес (BIA).
Точки восстановления — это моменты, к которым данные должны быть восстановлены. Это может включать частоту резервного копирования, так как она основана на методах использования данных. Например, часто обновляемая информация и файлы могут иметь точку восстановления в несколько минут, в то время как менее важные данные должны быть восстановлены в течение нескольких часов.
И цели времени восстановления, и цели точки восстановления представляют влияние на итоговую прибыль. Чем меньше эти значения, тем выше стоимость DRaaS.
Частью целей времени и точки восстановления должен быть график автоматизированных резервных копий. Учтите разницу во времени, необходимом для резервного копирования данных против приложений, и создайте два графика или отметьте различия в одном.
Создание индивидуального плана облачного резервного копирования и аварийного восстановления
Не существует волшебного черновика для решений резервного копирования и аварийного восстановления. Каждая компания должна изучить лучшие практики отрасли и определить критически важные рабочие нагрузки, необходимые для продолжения операций после потери данных или другой катастрофы.
Общий принцип, используемый для вывода плана IT-восстановления, — это триаж. Это процесс создания программы, начинающейся с идентификации и приоритизации сервисов, приложений и данных, и определения допустимого объема простоя до того, как катастрофа нанесет существенное воздействие на бизнес-операции. Эти усилия включают разработку набора целей времени восстановления (RTO), которые определяют, какой тип решения нужен бизнесу.
Идентифицируя критические ресурсы и соответствующие простой и восстановление, бизнес создает надежную основу для облачного DR-решения.
Все критические приложения и данные должны быть включены в этот план. С другой стороны, чтобы минимизировать затраты и обеспечить быстрое восстановление при внедрении стратегии, бизнес должен исключить все нерелевантные приложения и данные.
После идентификации и приоритизации приложений и данных определяются цели времени восстановления. Самый стоимоэффективный способ достижения целей — использовать отдельный метод для каждого приложения и сервиса.
Некоторым бизнесам может потребоваться отдельный метод для данных и приложений, работающих в их частных или публичных облачных средах. Скорее всего, этот сценарий вернет разные средства защиты кластеров приложений и данных с параллельными целями времени восстановления.
После завершения дизайна аварийного восстановления следует периодически проводить тесты, чтобы убедиться, что он работает как нужно. У многих компаний есть резервные копии, но они не знают, как их использовать, когда это необходимо. Поэтому нужно регулярно тестировать как внутренние, так и внешние процедуры и обновлять их по мере необходимости.
Общая рекомендация — тестировать системы ежегодно, внимательно следуя каждому шагу описанного процесса. Однако в компаниях с динамическими мультиоблачными стратегиями или теми, что расширяются в неравномерном темпе, эти тесты могут потребоваться чаще. По мере внедрения новых систем или обновлений инфраструктуры план аварийного восстановления должен обновляться для отражения изменений.
Также важно использовать инструмент мониторинга облака.
Варианты аварийного восстановления данных в облаке
Центры обработки данных предлагают различные варианты, которые бизнес может выбрать для защиты данных.
Управляемые приложения — популярный компонент облачной стратегии аварийного восстановления. В этом случае как основные производственные данные, так и резервные копии хранятся в облаке и управляются провайдером. Это позволяет компаниям получать преимущества облака в модели оплаты по использованию, уходя от зависимости от локальных резервных копий.
Управляемое или размещенное решение для восстановления предоставляет вам комплексную облачную платформу с необходимым оборудованием и ПО для поддержки ваших операций. При этом варианте данные и приложения остаются локально, а только данные резервируются в облачной инфраструктуре и восстанавливаются по мере необходимости. Такой вариант более стоимоэффективен, чем традиционный, например локальное внешнее резервное копирование. Однако процесс восстановления приложений может быть медленным.
Некоторые поставщики приложений уже могут предлагать облачные сервисы резервного копирования. Бизнесу стоит проверить у своих вендоров, есть ли такая возможность, чтобы сделать внедрение максимально простым. Еще один жизнеспособный вариант — резервное копирование в облачную инфраструктуру и восстановление из нее. Данные восстанавливаются на виртуальные машины в облаке, а не на локальные серверы, что требует облачного хранилища и вычислительных ресурсов.
Процесс восстановления может выполняться при возникновении катастрофы или быть регулярным. Регулярные бэкапы гарантируют актуальность данных через совместное использование ресурсов и необходимы, когда цели восстановления краткосрочны.
Для приложений и данных с короткими или агрессивными целями репликация на виртуальные машины в облаке — жизнеспособный сервис DRaaS. Реплицируя в облако, вы обеспечиваете защиту данных и приложений как в облаке, так и локально.
Репликация возможна для облачных VM в облачные VM и локальные в облачные VM. Продукты репликации в VM основаны на непрерывной защите данных.
Начало работы с облачным аварийным восстановлением
После того как бизнес определил, какой тип решения восстановления ему нужен, следующим шагом является обзор доступных вариантов у разных провайдеров и центров обработки данных.
Ключ к нахождению решения, соответствующего потребностям бизнеса — обсуждение вариантов с несколькими сервис-провайдерами.
Многие вендоры предлагают вариации в своих тарифных пакетах, которые могут включать определенное количество пользователей, резервное копирование приложений, данных и частоту бэкапов.
Единственный эффективный способ выбрать провайдера управляемого облачного резервного копирования и аварийного восстановления — адекватно оценить свои потребности. Обсудите потребности со всеми заинтересованными сторонами во всех отделах, чтобы выявить критические данные и приложения для обеспечения непрерывности бизнеса.
Определите цели времени восстановления (RTO) и точки восстановления (RPO) и создайте график с соответствующим простоями для данных и приложений. Затем учтите бюджет, выделенный на аварийное восстановление.
Изучите различные варианты, чтобы найти лучший для вашего бизнеса.
Облачные вычисления
- Перезарядка, сброс и переконфигурация вашей IT-стратегии для летнего успеха
- Понимание облачной безопасности: почему вашему бизнесу это нужно
- Big Data и облачные вычисления: как они работают вместе
- Защита облачных технологий: лучшие практики для защиты данных и митигации рисков
- 10 ключевых преимуществ облачного хранилища для современных бизнесов
- Ре‑платформинг в облаке: что это такое и как он обеспечивает эффективную миграцию
- Три мощных способа, которыми облачные вычисления улучшают IoT-развертывания
- Раскройте рост с облаком: 3 ключевых выгоды, которые должен знать каждый бизнес
- Промышленный интернет вещей (IIoT): определение, область и промышленное влияние
- Данные технического обслуживания: ключ к надежному управлению активами