



Ускорение ИИ на краю: решающая роль специализированных процессоров и памяти
ИИ больше не просто буззворд — это глобальный императив, движущий дизайном сегодняшних вычислительных платформ. Пока GPU питовали обучение массивных языковых моделей в дата-центрах, граница ИИ теперь лежит на краю, в энерго-ограниченных устройствах таких как IoT-сенсоры, камеры безопасности и автономные роботы.
Чтобы трансформировать миллиарды эндпоинтов из простых облачных агентов в автономные, он-девайс инференс-движки, мы должны оптимизировать и вычислить, и память. Метрика, которая действительно имеет значение — эффективность в тера-операциях в секунду на ватт (TOPS/W).
Вызовы реального времени Edge AI
По мере роста фундаментальных моделей до миллиардов параметров, стоимость и энергетический след дата-центровой инфраструктуры резко возрастают. Однако спрос на реальное-время, низколатентное инференс в источнике данных остается сильнее чем когда-либо. Edge AI должен поэтому выйти за пределы сырой вычислительной плотности и адресовать двойные ограничения ограниченных энергобюджетов и строгих целевых затрат.
На практике это означает балансировку сырой пропускной способности (TOPS) с пропускной способностью памяти и задержкой. Современные акселераторы такие как GPU доставляют беспрецедентные вычисления, но их производительность ограничена скоростью, с которой данные могут быть шаттлованы в и из памяти. Узкое место в памяти питает акселератор, отрицая выгоды более высокой вычислительной емкости.
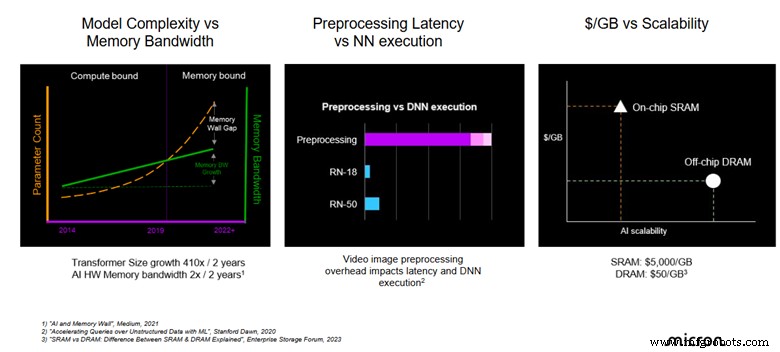
Ограничения пропускной способности памяти стали самым значительным ограничителем производительности во встроенном edge AI. Даже когда модели растут сложнее, медленный путь памяти может калечить реальное-время инференс.
Инференс — это пайплайн, начинающийся с сырых сенсорных данных, проходящий через предобработку, питающий квантованную нейросеть и заканчивающийся постобработкой, доставляющей действенные результаты. Если любое звено в этой цепи слабое — будь то низкопропускная шина памяти или медленная предобработка — вся система страдает.
Более того, добавление нейро-процессинговых единиц (NPU) или акселераторных ядер в систем-на-чип (SoC) дизайны может поднять bill-of-materials и снизить гибкость. Решение лежит в целевых ASIC-акселераторах, сочетающих высокий TOPS/W с компактными, низкоэнергетическими памятьными интерфейсами.
Выделенные ASICs доставляют множественные выгоды: они оптимизированы для арифметических паттернов нейросетей, могут быть настроены под широкий спектр моделей и обеспечивают лучшую возможную энергоэффективность для edge-деплойментов — будь то автономная фермерская машина, камера наблюдения или складской робот.
Синергия вычислений и памяти
Ко-процессоры, бесшовно интегрирующиеся с edge-платформами, разблокируют реальное-время глубокое-обучение инференс, держа потребление энергии и стоимость низкими. Они поддерживают разнообразные рабочие нагрузки, от vision transformers до больших языковых моделей.
Примерный иллюстрация этой синергии — партнерство между Hailo edge AI акселератором и Micron низкоэнергетическим DDR (LPDDR) памятью. Вместе они предоставляют сбалансированный compute-memory микс, необходимый для оставания в тугих энергетических и бюджетных конвертах.
LPDDR технология Micron доставляет высокоскоростной, высокопропускной передачу данных без компромисса энергоэффективности. Используемая в смартфонах, ноутбуках, автомобильной электронике и промышленных контролах, LPDDR идеально подходит для ИИ рабочих нагрузок, требующих быстрый I/O и низкую задержку.
LPDDR4/4X поддерживает до 4,2 Гб/с на пин с шириной шины до x64. LPDDR5/5X Micron толкает это до 9,6 Гб/с на пин и предлагает 20% лучшую энергоэффективность чем LPDDR4X, предоставляя пропускную способность, требуемую для самых требовательных edge AI моделей.
Hailo, лидер в ИИ кремнии, использует этот память-партнерство для доставки процессоров таких как Hailo-10H, достигающего до 40 TOPS. Его data-flow архитектура выстраивается со статистическими свойствами нейросетей, позволяя edge-устройствам запускать сложные модели в полном масштабе, держа затраты низкими.
Применение решения на практике
Hailo-15 VPU SoC адаптирован для умных камер и vision-интенсивных приложений. Он соединяет инференс-двигатель Hailo с передовыми компьютер-вид пайплайнами, доставляя премиальное качество изображения и сложную видео-аналитику в едином, энергоэффективном пакете.
LPDDR4X Micron, строго протестированный по авто, промышленным и энтерпрайз средам, идеально парирует с Hailo-15 VPU. Результат — решение, доставляющее высокую пропускную способность, низкую задержку и некомпрометированную энергоэффективность, даже в экстремальных температурных диапазонах.
Выигрышная комбинация
По мере эволюции экосистемы, разработчики должны переосмыслить миллионы — даже миллиарды — устройств как полностью автономные edge AI платформы. Успех зависит от процессоров, построенных с нуля для ускорения нейронных рабочих нагрузок, и низкоэнергетической, высокопроизводительной памяти, держащей данные движущимися плавно.
Когда процессоры и память оптимизированы вместе, edge AI может масштабироваться к новым приложениям, от автономного фермерского оборудования до реального-времени видео-наблюдения и робототехники.
SPONSORED ARTICLE
Комментируйте эту статью через X: @IoTNow_ и посетите нашу домашнюю страницу IoT Now
Интернет вещей
- IoT World Awards 2023: празднование победителей, драйвящих инновации
- Умное освещение: Будущее интеллектуального освещения
- B2B продуктовая инновация: стратегическая дорожная карта для продуктовых менеджеров
- WiFi против Cellular для M2M: ключевые различия и идеальные кейсы
- Бесшовная интеграция Modbus-сенсоров с EdgeX Foundry на Raspberry Pi
- AirFinder Industrial OnSite XLE: ультра-долгая жизнь батареи и точное отслеживание активов
- Могут ли Apple AirTags отслеживать коммерческие активы? Практическая оценка
- GPS vs RFID: выбор правильной технологии отслеживания активов
- Пограничные вычисления объяснены: почему они критичны для современного бизнеса
- Ускорение глубокого обучения с FPGA: скорость, гибкость и энергоэффективность