



Ускорение CPU‑FPGA Co‑Design: Практический поток для разработчиков ПО
Недавно Брайан Бейли собрал круглый стол, завершившийся двухчастной статьей Supporting CPUs + FPGAs. Эксперты обсуждали эволюционирующую реальность систем, сливающих FPGA с CPU, подсвечивая, как новые потоки проектирования позволяют разработчикам ПО быстрее выводить CPU+FPGA платформы на рынок.
Введение
Всплеск искусственного интеллекта, взрыв подключенных устройств и ускорение рабочих нагрузок дата-центров указывают на один общий драйвер: разработчики ПО, ищущие скорость. Низколатентные связи между FPGA и CPU, в сочетании с скромными энергопотреблениями современных FPGA, делают гибридные CPU-FPGA системы естественным выбором для требовательных задач. Однако базовая сложность FPGA-технологии часто застревает разработчиков.
Инструменты высокоуровневого синтеза (HLS) значительно продвинулись, облегчая отображение C/C++ в железо. Тем не менее, они в основном IP-центричны и недостаточны для системных решений — балансировки ПО против железа, выбора между конвейеризированным или параллельным выполнением, настройки гранулярности данных или выбора оптимальных механизмов коммуникации.
Разработчикам ПО нужен унифицированный поток проектирования, ощущающийся как стандартная IDE для ПО, но доставляющий железо-осведомленную обратную связь. Недавние коммерческие решения начали закрывать этот разрыв, абстрагируя низкоуровневые детали, сохраняя контроль, который требуют разработчики. Эти инструменты заземлены в философии System-Level Design, описанной в ESL Models and Their Application.
Понимание потока System-Level Design
System-Level Design работает на более высоком уровне абстракции, валидируя, уточняя и интегрируя системные компоненты до реализации. Большинство дизайнеров начинают на алгоритмическом уровне, пиша C/C++/SystemC, MATLAB, Simulink или LabVIEW модели, захватывающие полное поведение системы.
Мы фокусируемся на C/C++-центричном потоке (см. Рисунок 1). Первый этап — профилирование приложения — выявляет, какие функции или циклы могут выиграть от аппаратного ускорения. Далее задается целевая CPU/FPGA платформа (например, ARM-Cortex-A53 + FPGA) и её параметры (такт, кэш, интерконнекты). Наконец, профилируемые задачи отображаются между ПО и железом, кульминируя в исполнимой архитектуре.
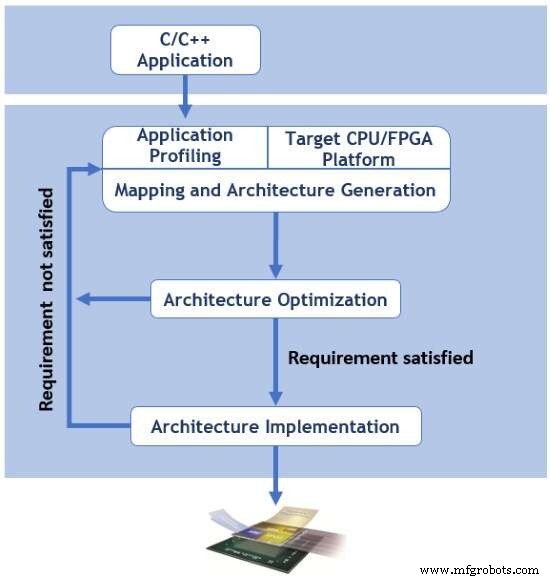
Рисунок 1. Типичный system-level design flow для CPU/FPGA (Источник: Space Codesign Systems, Inc.)
Второй блок Рисунка 1 охватывает оптимизацию архитектуры — иногда называемую архитектурным исследованием или верификацией производительности — показанную детально на Рисунке 2.
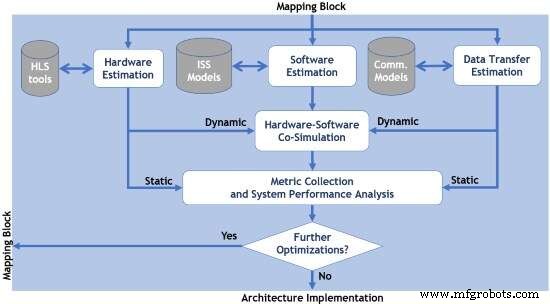
Рисунок 2. Процесс оптимизации архитектуры (Источник: Space Codesign Systems, Inc.)
Три ключевых оценивателя питят эту стадию:
- Оценка железа оценивает влияние переноса C/C++ кода на FPGA, разбивая использование ресурсов, латентность циклов и мощность. Опирается на выходы HLS.
- Оценка ПО измеряет CPU-метрики — нагрузку процессора, переключение задач, промахи кэша — дополняя железный взгляд.
- Оценка передачи данных моделирует интерфейсы (memory-mapped или streaming), захватывая латентность шины, пропускную способность, глубину очереди и память.
Агрегированные результаты заполняют базу данных, позволяя разработчикам проверить, достигнуты ли системные цели. Архитектуры, удовлетворяющие критериям, идут вперед; иначе запускаются дальнейшие итерации оптимизации.
Финальный блок Рисунка 1 касается реализации архитектуры: высокоуровневые дизайны переводятся в FPGA битстримы с использованием вендорских инструментов вроде Xilinx Vivado или Intel Quartus Prime, производя полностью синтезированную и тестируемую систему, готовную к развертыванию.
System-Level Optimization
Отсутствие автоматизированных end-to-end инструментов оптимизации долго было узким местом в FPGA-вычислениях. Сложность балансировки множественных измерений делает ручное исследование утомительным даже для опытных дизайнеров.
Рисунок 3 иллюстрирует типичный рабочий процесс оптимизации для изображения-обработки приложения, состоящего из шести C/C++ функций, развернутых на платформе Zynq-7000. Рассматривается восемь кандидатов архитектур, но ограничения time-to-market требуют быстрого выбора лучшего компромисса между производительностью, площадью и мощностью.
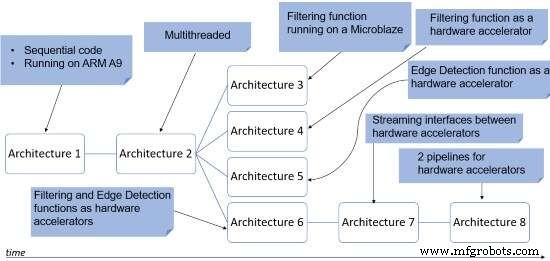
Рисунок 3. Архитектурное исследование с подсветкой system-level решений (Источник: Space Codesign Systems, Inc.)
Коммерческие решения вроде Xilinx SDSoC/SDAccel, Falcon Computing Merlin Compiler и Space Codesign SpaceStudio теперь предоставляют end-to-end поддержку. Они зеркалят поток на Рисунках 1 и 2, внедряя автоматизированную логику решений:
- SDSoC оценивает латентности для железных ядер и характеризует передачу данных на целевой платформе, затем бенчмаркает против чисто-программного запуска.
- Merlin Compiler применяет source-to-source трансформации, управляемые четырьмя прагмами, плюс неявные компиляторные проходы, усиливающие конвейеризацию и параллелизм.
- SpaceStudio строит виртуальную платформу (VP), симулирующую всю систему, интегрируя железо-генерированные латентности и предлагая неинвазивный профилинг как ПО, так и железа задач.
Взгляд на коммерческую экосистему
Рисунок 4 представляет слоистый взгляд на экосистему, окружающую CPU/FPGA платформенный дизайн. Верхний слой показывает алгоритмические точки входа; средний слой хостит инструменты, поддерживающие system-level оптимизации из C/C++; нижний слой содержит вендорские синтезные инструменты, производящие битстримы. Репрезентативные CPU/FPGA платформы проиллюстрированы в базе.
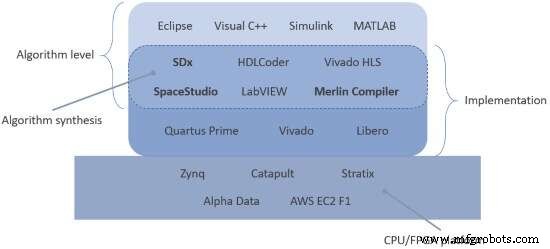
Рисунок 4. Коммерческая экосистема для CPU/FPGA платформ (Источник: Space Codesign Systems, Inc.)
Таблица 1 перечисляет ключевые коммерческие инструменты автоматизации, используемые в CPU/FPGA платформенном дизайне.
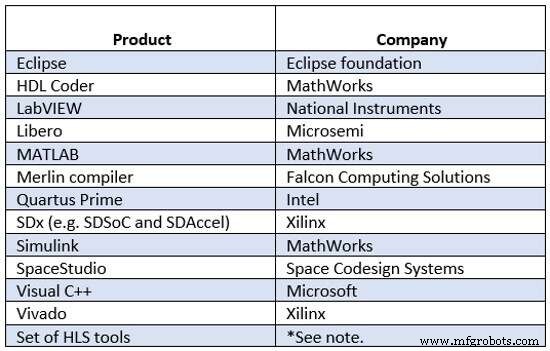
Таблица 1. Коммерческие инструменты автоматизации (*Примечание: список предложен в этом обзоре)
Заключение
Демократизация CPU+FPGA разработки — конечная цель, позволяющая более широкому кругу разработчиков ПО использовать аппаратное ускорение. Как софт-индустрия эволюционировала от ассемблера к Python и Swift за пять десятилетий, FPGA-программирование проходит похожую зрелость. Взлет system-level инструментов вроде SpaceStudio, SDSoC и Merlin Compiler сигнализирует о ключевом сдвиге — но полная автоматизация и бесшовная оптимизация через компиляторы остаются будущими вехами.
Гай Бואה, Ing., PhD — основатель Space Codesign Systems и профессор Департамента программной и компьютерной инженерии в Политехнике Монреаль. С обширным R&D опытом рядом с лидерами индустрии — STMicroelectronics, Grass Valley, PMC Sierra, Design Workshops Technologies и Cadabra Systems — экспертиза Гая в hardware/software co-design привела к коммерциализации SpaceStudio и основанию Space Codesign Systems Inc.
Встроенный
- CEO AMendate Томас Райер: революция 3D-печати с автоматизированной топологической оптимизацией
- Рави Кундью из Altair о симуляционно-ориентированном дизайне и новом Inspire Print3D для 3D-печати
- 5 проницательных вопросов Стефану Ферберу, CEO Bosch.IO
- Инициатива VE-VIDES раскрывает надежный фреймворк дизайна и верификации для безопасности IoT
- Cadence запускает ML-ориентированный инструмент Cerebrus для повышения продуктивности дизайна чипов в 10x и PPA на 20%
- Cadence и UMC сертифицируют 28HPC+ AMS дизайн‑флоу для ускоренной разработки авто, IoT и AI чипов
- Улучшение 저비용 로봇-платформ: новая 7-я ось и бесплатное ПО цифрового двойника
- Infineon и Elektrobit доставляют next-gen безопасность для коннектед автомобилей
- Omron представляет Flow Core: передовое ПО для повышения надежности и гибкости мобильных роботов
- Навигация по новому производственному ландшафту: Стратегии успеха