



MLCommons представляет MLPerf Inference Benchmark 2024: результаты для Edge, Data Center, Mobile и Notebook
MLCommons, независимая организация, курирующая набор бенчмарков MLPerf, объявила последний раунд оценок MLPerf Inference. Новые результаты аккуратно разделены на четыре класса устройств — центр обработки данных, пограничные, мобильные и ноутбуки — облегчая покупателям, поставщикам и исследователям сравнение производительности по реальным рабочим нагрузкам.
Сегментация по классам устройств
Разделение оценок по классам устройств отражает отличительные форм-факторы и профили производительности, характеризующие каждый рынок. Как Дэвид Кантер, исполнительный директор MLCommons сказал EE Times, «Если вы говорите о ноутбуке, он, вероятно, работает на Windows; если вы говорите о смартфоне, вы, вероятно, работаете на iOS или Android». Изолируя мобильные и ноутбук результаты, бенчмарк предоставляет более четкие инсайты в возможности наиболее релевантных ускорителей для каждого варианта использования.
Модели передового уровня
В отличие от предыдущего раунда, который фокусировался в основном на задачах зрения, текущий бенчмарк включает пять современных, производственных моделей:
- DLRM — масштабируемый рекомендательный движок
- 3D-UNet — медицинская имиджинговая модель для обнаружения опухолей в МРТ сканах
- RNN-T — речевой движок в текст
- BERT — трансформер обработки естественного языка
- MobileNetEdge, SSD-MobileNetv2, Deeplabv3 и Mobile BERT — мобильно-оптимизированные варианты вышеперечисленных
Эти выборы были продиктованы советским советом, включающим отраслевых экспертов из рекомендаций, медицинского изображения и речевых доменов, обеспечивая, что бенчмарки отражают самые требовательные производственные рабочие нагрузки сегодня.
Производительность центра обработки данных
Как ожидалось, GPU Nvidia доминируют в классе центра обработки данных. Фактически, 85% от общего количества представлений были поделены на Nvidia оборудование, и компания завоевала каждую категорию, в которую вошла. Бенчмарк показывает расширяющийся разрыв в производительности: на базовой модели компьютерного зрения Nvidia A100 доставляет примерно 30x пропускную способность Intel Cooper Lake CPU, и 237x быстрее чем сопоставимый CPU на рекомендательных системных рабочих нагрузках. Пареш Хьяра, старший директор управления продуктом Nvidia, подчеркивает, что один DGX-A100 может соответствовать производительности 1000-узлового CPU кластера для рекомендательных задач, предлагая огромную ценность для масштаба.
Единственный не-CPU, не-GPU участник в этом классе — ускоритель Zebra Mipsology, работающий на FPGA Xilinx Alveo U250. Zebra достиг 4096 ResNet запросов в секунду в серверном режиме против 5563 для Nvidia T4, и 5011 сэмплов в секунду офлайн по сравнению с 6112 для T4.
В категории исследования-разработки RecAccel тайваньской компании Neuchips — FPGA-базированный ускоритель для DLRM — выполнился на уровне или ниже CPU Intel Cooper Lake и уступил результатам Nvidia. Эти ранние прототипы демонстрируют широту الناشствующего AI-железа, даже если они еще не коммерчески доступны.
Результаты пограничного уровня
Пограничные системы в основном питались Nvidia A100, T4, AGX Xavier и Xavier NX чипами. Эталонный дизайн Centaur Technology, с его проприетарным x86 процессором и отдельным AI-копроцессором, обыграл Nvidia Tesla T4 в однопоточной задержке ResNet, но отстал в пропускной способности. Британская консалтинговая dividiti представила широкий спектр оценок — от Raspberry Pi до Nvidia AGX Xavier — подчеркивая, как выбор операционной системы и использование набордовых ускорителей могут влиять на результаты.
Новые участники из пула исследования-разработки включали российскую компанию IVA Technologies и корейский стартап Mobilint. Хотя ни один не достиг прорывной производительности, их включение показывает, что прототипные ускорители достигают уровня зрелости ПО, который оправдывает бенчмаркинг против коммерческих решений.
Мобильные и ноутбук бенчмарки
Мобильный класс видел три сопоставимых представления: MediaTek Dimensity 820 (в Xiaomi Redmi 10X 5G), Qualcomm Snapdragon 865+ (тестированный на Asus ROG Phone 3) и Samsung Exynos 990 (использованный в Galaxy Note 20 Ultra). Samsung лидировала в классификации изображений и NLP, MediaTek преуспела в обнаружении объектов, и Samsung снова превзошла в сегментации изображений. Результаты иллюстрируют, что ни один SoC не доминирует во всех задачах, подчеркивая важность оптимизации под конкретную рабочую нагрузку.
Категория ноутбуков содержала единственный эталонный дизайн Intel с грядущим Xe-LP GPU. Хотя ограниченный набор данных затрудняет детальное сравнение, Xe-LP достиг 2,5x более высокой пропускной способности чем лучший мобильный SoC на сегментации изображений (DeeplabV3) и 1,15x лучше на обнаружении объектов (SSD-MobileNetv2).
Взгляд в будущее
Кантер подчеркивает приверженность MLCommons разнообразию в экосистеме бенчмарков. Организация поощряет участие не-Nvidia, не-Intel и малых компаний, с открытым дивизионом, позволяющим тестировать любую сеть или модель. «Мы также работаем над добавлением измерения мощности для следующего раунда», — говорит Кантер, приглашая сообщество помочь разработать необходимый инструментарий.
Для полного, детального списка результатов MLPerf Inference, нажмите здесь.
Источник: EE Times
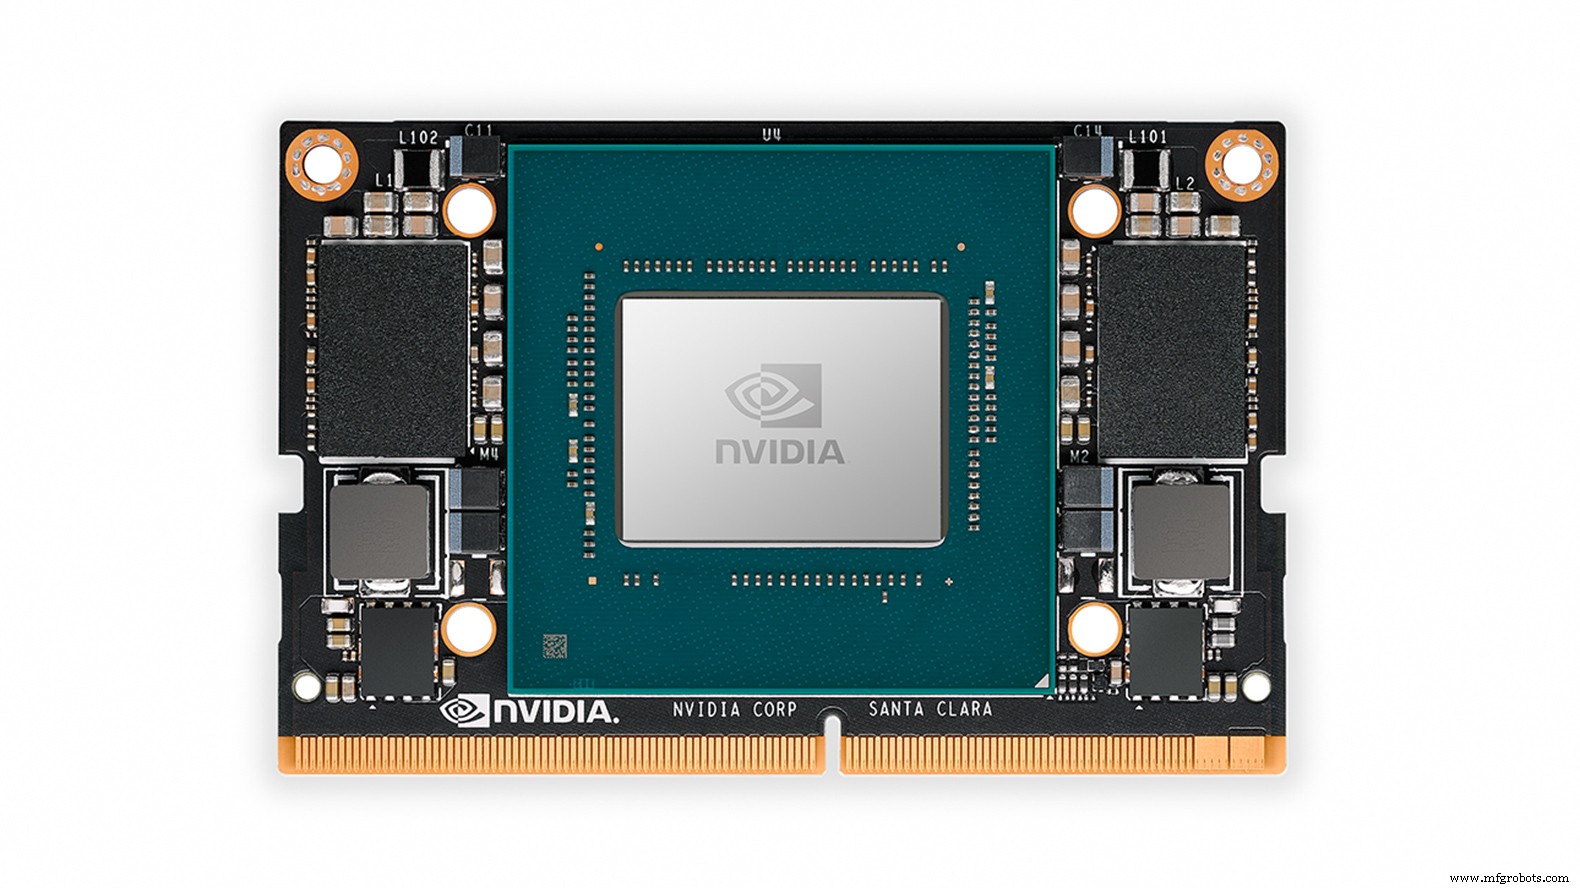
Пограничные результаты доминированы Nvidia GPU, включая Jetson Xavier NX
Встроенный
- STMicroelectronics LSM6DSOX: инерциальный датчик с машинным обучением для точного, энергоэффективного трекинга активност…
- ADLINK и Charles Industries представляют первое полное микро-краевое AI/ML решение для 5G столбовых развертываний
- NXP ускоряет Edge AI с инструментарием eIQ
- Edge AI: Почему обработка данных смещается на уровень устройств
- Повышение производительности: передовые функции вертикальных машцентров (VMC)
- Повысьте эффективность edge computing с надежной Wi-Fi сетью
- Машинное обучение ускоряет безопасность трубопроводов: детекция дефектов в реальном времени сэкономила $10 м…
- Периферийные вычисления: новое сердцебение эпохи облака
- Johnford ST-80 CH: высокоточный CNC-токарный центр для тяжелых отраслей
- Высокопроизводительный четырехосевой вертикальный токарный станок VTC 100-4 для валовой обработки