



Использование DSP для аудио AI в реальном времени на краю сети
Использование DSP для аудио AI в реальном времени на краю сети
Когда-то ограниченное облачными серверами с практически неограниченными ресурсами, машинное обучение теперь переходит на краевые устройства. Меньшая задержка, сниженная стоимость, энергоэффективность и повышенная конфиденциальность движут этот сдвиг. Например, беспилотный автомобиль не может позволить задержку отправки данных в облако для распознавания пешеходов, а затраты на пропускную способность могут сделать облачное распознавание речи недопустимым.
Почему важна обработка на краю
Энергетические компромиссы между передачей данных и локальным выводом критичны. Сложные рабочие нагрузки ML могут быстро сажать батарею устройства, если не выполняются эффективно. Локальный вывод также сохраняет конфиденциальные данные — такие как голосовые письма — на устройстве, защищая приватность пользователя.
Низкопотребляющее всегда активное голосовое пробуждение
Распознавание ключевых слов (например, «Hey Siri» или «OK Google») — один из самых ранних сценариев edge-ML. Запуск такого обнаружения на универсальном прикладном процессоре может потреблять более 100 мВт, быстро разряжая батарею смартфона. Ранние телефоны перенесли алгоритм на небольшой DSP, работающий при <5 мВт, а современные умные микрофоны выполняют ту же задачу на специализированном аудио-ML DSP при <0,5 мВт.
За пределами голоса: расширение возможностей на краю
Как только устройство поддерживает всегда активное аудио ML, оно может распознавать контекстные подсказки: шумные рестораны, оживленные улицы, фоновую музыку, ультразвуковые сигнатуры помещений, близкие крики и смех. Эти функции позволяют сложные сценарии использования, полезные как для устройства, так и для пользователя.
Создание Edge AI DSP
Для максимальной производительности и энергоэффективности edge-вывода требуется специализированное железо. Наиболее влиятельные техники сведены в таблице ниже.
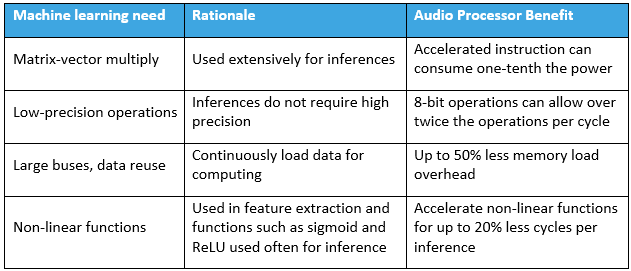
Нейросетевой вывод сильно опирается на матрично-векторные умножения (MVM). Операция объединенного умножения-накопления (MAC) является краеугольным камнем эффективного выполнения MVM. Низкоточная арифметика — часто 8-бит — достаточно для вывода, что резко снижает вычислительную сложность. Intel и Texas Instruments, например, предлагают процессоры с выделенными низкоточными MAC-блоками: TI TMS320C6745 выполняет 8 MAC 8-битных операндов за цикл, в то время как аудио DSP Knowles может выполнять 16 таких MAC за цикл.
И обучение, и вывод требуют значительной пропускной способности памяти. Широкие шины данных снижают давление: AVX-512 Intel поддерживает передачу 512 бит за цикл в массив из 64 умножителей; TI 6745 использует 64-битную шину; процессоры Knowles используют 128-битную шину, балансируя площадь кристалла и пропускную способность. Рекуррентные архитектуры (RNN, LSTM) требуют обратных связей, накладывающих дополнительные архитектурные ограничения, которые могут блокировать глубоко конвейеризированные дизайны.
Аудио-ML конвейеры обычно начинаются со спектрального анализа и извлечения признаков. Ускорение классических DSP-операций — БПФ, фильтров, тригонометрических и логарифмических функций — критично для энергоэффективности. Нелинейные векторные операции (sigmoid, ReLU и др.) также выигрывают от однотактных инструкций, дополнительно снижая количество циклов и потребление.
Короче, процессоры, объединяющие ускорение машинного обучения и аудиосигналов, позволяют выполнять вывод в реальном времени, всегда активный, при низкой стоимости с сохранением приватности. Архитектурные выборы — наборы инструкций с множественными операциями, широкие шины и специализированные низкоточные блоки — поддерживают высокую производительность без высокого потребления. По мере развития специализированных edge-вычислений спектр реализуемых ML-сценариев будет расширяться.
Джим Стил, вице-президент по стратегии технологий, Knowles Corp.
© Эта статья была первоначально опубликована на EE Times: «Машинное обучение на DSP: включение аудио AI на краю».
Интернет вещей
- Использование машинного обучения для оптимизации управления цепочкой поставок MRO
- Edge Computing: разблокировка real-time данных, повышение эффективности и новые доходы
- NXP ускоряет Edge AI с инструментарием eIQ
- Edge AI: Почему обработка данных смещается на уровень устройств
- Как выбрать идеальный станок с ЧПУ для долгосрочной эффективности
- Освоение пульта DSP: ключевые правила для оптимальной работы
- Машинное обучение ускоряет безопасность трубопроводов: детекция дефектов в реальном времени сэкономила $10 м…
- Intel и Udacity запускают сертифицированную программу по Edge AI разработке
- Почему открытый исходный код движет инновациями на периферии — важная электронная книга
- Управление машино-ориентированным интернетом: революция периферийных вычислений