



Улучшенная обработка документов: объединение подходов на основе правил и моделей для точной автоматизации
Информация — сила. Для большинства компаний множество ценной бизнес-информации заперто в документах. Учитывая разнообразие типов, размеров и форматов документов, которые компании часто управляют, эффективная обработка документов для получения инсайтов может быть сложной.
Здесь, в UiPath, мы понимаем этот вызов. Благодаря нашему новейшему фреймворку понимания документов, наши клиенты могут легко автоматизировать извлечение и обработку данных для широкого спектра документов независимо от их типа, формата или объема. Это помогает вам подходить к обработке документов с гибкостью, используя любой процесс, который лучше всего подходит для ваших уникальных потребностей.
Для более высокого взгляда на преимущества понимания документов, ознакомьтесь с нашим техническим документом Повышение операционной эффективности и снижение рисков с Document Understanding.
В этой статье мы:
Рассмотрим распространенные типы и классификации документов
Изучим методы извлечения данных на основе правил и на основе моделей
Посмотрим на распространенные проблемы, с которыми компании сталкиваются при применении каждого из этих стандартных подходов к обработке документов
Рассмотрим выгоды, которые компании могут получить, если оба подхода к обработке документов объединены как мульти-подходный метод извлечения данных
Начнем.
Ландшафт документов
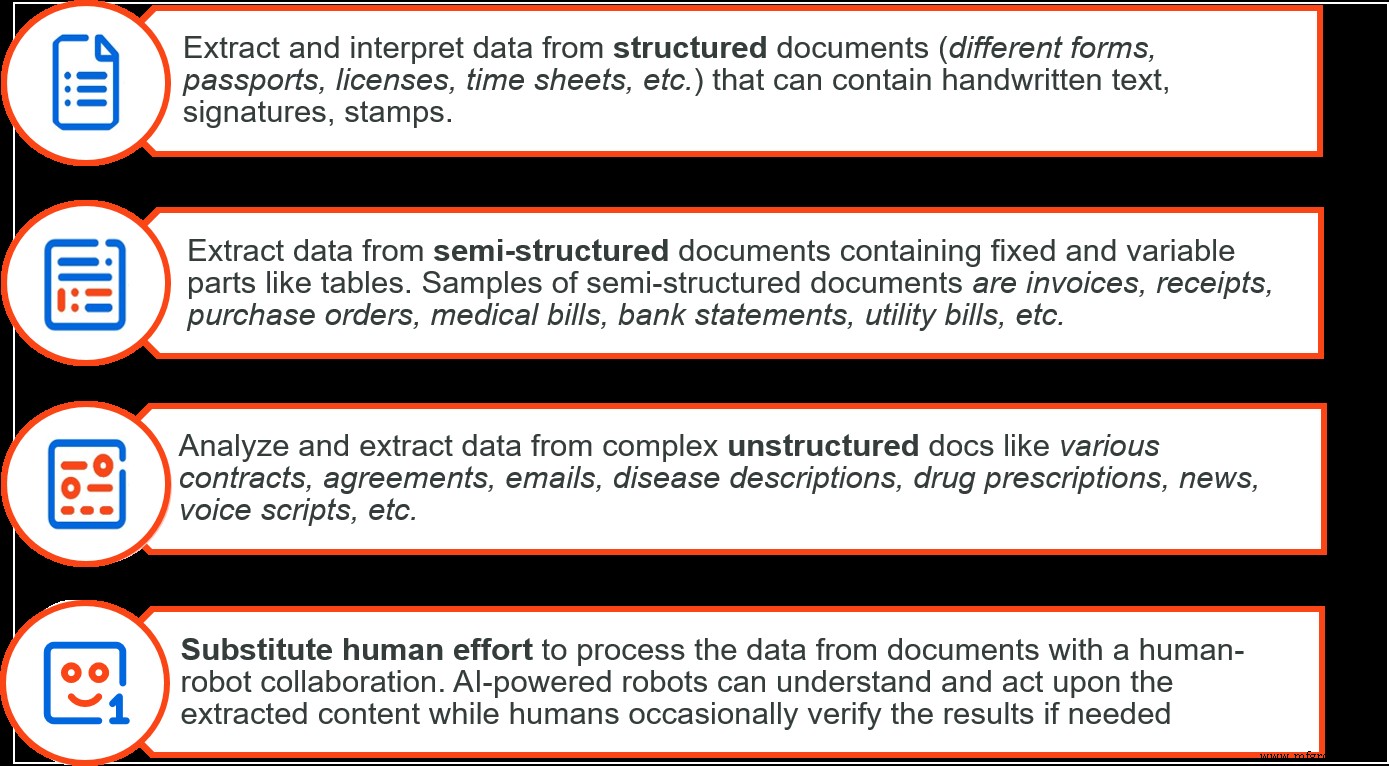
В зависимости от их структуры и формата, документы можно классифицировать на три типа.
1. Многие документы, такие как налоговые формы, остаются фиксированными в формате — они называются структурированными документами.
2. Другие, такие как договоры, не имеют стандартной структуры — их называют неструктурированными документами.
3. Наконец, документы, имеющие различные качества, такие как переменные макеты или дизайны, но включающие похожие типы информации, называются полуструктурированными документами. Чекы, счета-фактуры и заказы на закупку — распространенные примеры документов в этой категории.
Основываясь на классификации документов, есть два распространенных типа методологий извлечения данных. Извлечение на основе правил нацелено на структурированные документы, в то время как извлечение на основе моделей используется для обработки полуструктурированных и неструктурированных документов.
Преимущества и ограничения методов извлечения данных на основе правил
Извлечение данных на основе правил опирается на набор правил для извлечения данных из документа. Например, вы можете создавать шаблоны документов и применять правила на основе конкретной позиции данных. Альтернативно, не создавая шаблоны, вы можете просто применять правила на основе того, как часто некоторые наборы данных используются в документе (паттерны встречаемости) или как эти переменные данных обычно выглядят в последовательности символов (регулярные выражения или regex).
Первое полезно при работе с формами, которые могут быть шаблонизированы, а второе используется, если возможно и легко создать такие правила. Мы обнаруживаем, что методы на основе правилов легко настраивать и понимать, и они очень эффективно работают в обработке документов. Однако они ограничены структурированными документами и только в нескольких простых случаях — полуструктурированными.
Итак, хотя методы извлечения данных на основе правилов полезны во многих контекстах, у них очевидные ограничения применения. Поскольку извлечение на основе шаблонов тесно связано с фиксированным макетом документа, любые изменения в макете могут нарушить правила и потребовать перенастройки правил.
Аналогично, regex-техники могут быть сложны для внедрения, отладки и громоздкими по мере усложнения ситуаций. Однако есть альтернативный подход к решениям на основе правил — подход на основе моделей.
Преимущества и ограничения методов извлечения данных на основе моделей
Методологии извлечения данных на основе моделей основаны на машинном обучении (ML). Эти методы мощны благодаря своей способности учиться на разнообразном наборе документов. Мы используем эти методы, применяя изощренные техники, такие как обработка естественного языка (NLP) и статистическое обучение.
UiPath Validation Station вооружает пользователей возможностью human-in-the-loop, чтобы модели могли учиться на лету и адаптироваться к изменениям в данных. ИИ-наполненная технология обычно используется для извлечения данных из полуструктурированных и неструктурированных документов. У нас, например, созданы ML-модели для использования в нашем фреймворке понимания документов для решения сценариев, таких как обработка чеков и счетов-фактур.
Читайте также: Использование ИИ для автоматизации обработки счетов-фактур и чеков
Вызов использования методов извлечения на основе моделей — это время и экспертиза, которые могут потребоваться для создания и внедрения ML-моделей. Во многих сценариях, однако, методы на основе моделей превосходят в своей способности учиться и адаптироваться к разным структурам и включениям документов.
Принятие мульти-подходного извлечения данных
Нет волшебной пули для решения всех потребностей в обработке документов. Оба подхода — на основе правил и на основе моделей — для извлечения данных являются мощными инструментами, но ограничены в своих способностях оптимально обрабатывать спектр документов, которыми управляют компании.
Некоторые структурированные документы могут потребовать гораздо больше, чем просто методологий на основе правил, так как некоторые данные не могут быть извлечены с помощью правил или шаблонов. Подобно этому, исключительно методы на основе моделей не работают для всех неструктурированных и полуструктурированных документов.
Мы хотим, чтобы пользователи могли легко комбинировать разные подходы для извлечения информации из одного документа. Поэтому мы спроектировали наш фреймворк понимания документов, чтобы дать вам силу преодолеть ограничения, накладываемые любым индивидуальным подходом. Мы настоятельно рекомендуем использовать мульти-подходное извлечение данных, когда вы имеете дело со сложными документами и хотите достичь наивысших уровней точности в процессе извлечения данных.
Быстрое и точное мульти-подходное извлечение данных
Используя наш гибкий фреймворк, вы можете комбинировать подходы к обработке документов, просто перетаскивая несколько техник извлечения данных прямо в ваш рабочий процесс в UiPath Studio.
Вы можете легко настроить экстракторы для обработки данных, установить порядок предпочтения для выполнения извлечения и установить значение как порог для определенных результатов экстрактора, чтобы они принимались как валидные. Таким образом, ни переменная структура документов, ни сложные правила для извлечения данных не станут проблемой. В то же время, в рамках сквозной автоматизации, вы получаете более быструю и намного более точную обработку документов с новейшей технологией ИИ.
Заинтересованы?
Наличие эффективных и точных возможностей извлечения и обработки документов критически важно. Через наш акцент на мульти-подходном извлечении данных мы хотим сделать обработку и анализ документов максимально легкими для клиентов UiPath.
В настоящее время расширенные возможности и функциональность Document Understanding доступны как Software-as-a-Service (SaaS) в бета-версии для пользователей, участвовавших в ранних пилотах. Вы можете ожидать, что эти функции и другие продвинутые инструменты Document Understanding будут доступны скоро. Тем временем мы рекомендуем вам зарегистрироваться для UiPath enterprise trial, чтобы получить доступ к решению UiPath Document Understanding.
Система управления автоматикой
- Армия США развивает состояние-ориентированное обслуживание с инновационными датчиками и предиктивной анали…
- Гигиенический дизайн для пищевой и перерабатывающей промышленности: от чистоты к экономии затрат
- Как IIoT и аналитика данных трансформируют EHS: повышение безопасности, эффективности и экономии
- Как сенсорные и операционные данные движат прибыльность ведущего производителя грузовиков
- Edge AI: Почему обработка данных смещается на уровень устройств
- Fog Computing: трансформация потока данных IoT и снижение нагрузки на облако
- Революция в управлении автопарками: интеграция ИИ и IoT для более умных операций
- ABB представляет передовую облачную автоматизацию для дата-центров
- Ambarella, Lumentum и ON Semiconductor презентуют ИИ-решения 3D-сенсинга для AIoT нового поколения
- Промышленный ИИ и предиктивная аналитика: ускорение производственной эффективности