



BrainChip запустила комплекты разработки Akida нейроморфные для Edge AI
BrainChip, ведущий провайдер нейроморфных вычислительных IP, представила два новых комплекта разработки с ее нейроморфным SoC Akida на недавней Linley Fall Processor Conference. Комплекты поставляются в формате x86 Shuttle PC и Arm-базированном дизайне Raspberry Pi, давая разработчикам готовые к использованию платформы для построения и тестирования spiking neural network (SNN) приложений. Akida кремний также доступен для интеграции в кастомные дизайны.
Нейроморфная архитектура Akida доставляет ультра-низкоэнергопотребляющий AI, имитируя event-driven обработку мозга. В отличие от конвенциональных deep-learning моделей, SNN передают информацию через дискретные спайки, кодирующие как пространственные паттерны, так и временные последовательности. Этот event домен идеален для пограничных устройств, требующих real-time, power-conscious инференса из сенсорных потоков.
Помимо нативных SNN-нагрузок, нейронные обработки блоки (NPU) BrainChip могут выполнять сверточные нейронные сети (CNN) после их конвертации в event домен. Конвертация, выполняемая MetaTF программным флоу, сохраняет CNN feature extraction в то время как позволяет on-chip обучение через spike-timing dependent пластичность — устраняя необходимость в cloud-базированном переобучении.
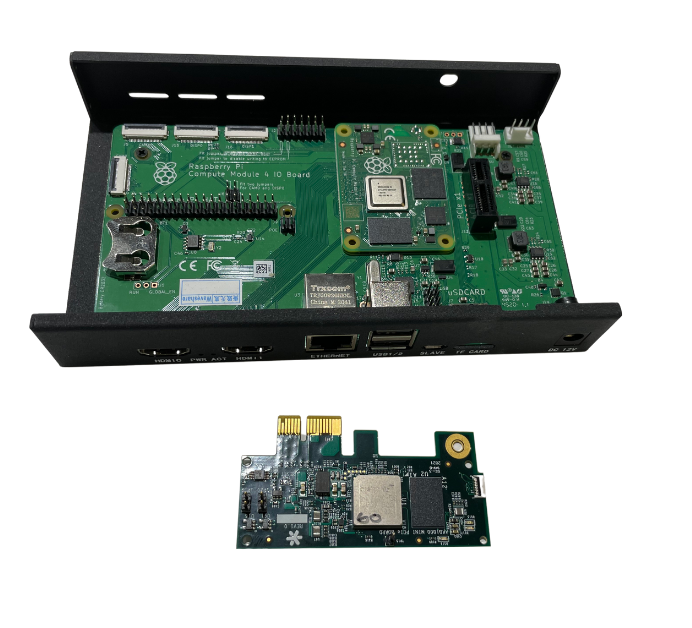
Отладочные платы BrainChip доступны для x86 Shuttle PC или Raspberry Pi. (Источник: BrainChip)
«Akida готова для завтрашней нейроморфной технологии, но уже решает сегодняшние edge AI вызовы», — сказал Анил Манкар, сооснователь и chief development officer BrainChip, EE Times. «Наш runtime софт удаляет кривую обучения вокруг SNN и event домена, позволяя разработчикам, знакомым с TensorFlow или Keras, портировать модели и оценивать мощность и точность прямо на нашем железе.»
Манкар объяснил, что CNN отлично извлекают признаки из больших датасетов. Конвертируя CNN-слои в event-базированные операции — кроме финального классификационного слоя — Akida сохраняет эту способность добавляя spike-timing обучение. Нативные SNN могут использовать одно-битную точность, в то время как конвертированные CNN обычно используют 1-, 2- или 4-битные спайки. Квантование инструмент BrainChip помогает дизайнерам выбирать подходящую бит-ширину на слой. Например, модель MobileNet V1, квантованная до 4 бит, достигла 93,1% точности на 10-классовой классификационной задаче.
Конвертация в event домен также дает значительную экономию мощности за счет разреженности. В event домене только ненулевые значения активации генерируют спайки, и NPU обрабатывает только те события. Для типичной CNN примерно половина активаций нулевы после ReLU, так что event-базированная реализация драматически снижает количество MAC-операций, снижая потребление мощности.
Функции такие как свертка, point-wise свертка, depth-wise свертка, max pooling и global average pooling могут быть все переведены в event домен. Следующая диаграмма иллюстрирует снижение MAC-операций для задачи классификации объектов: темно-синий представляет традиционную CNN, светло-синий показывает event-домен Akida реализацию, а зеленый указывает на дальнейшую регуляризацию активности.
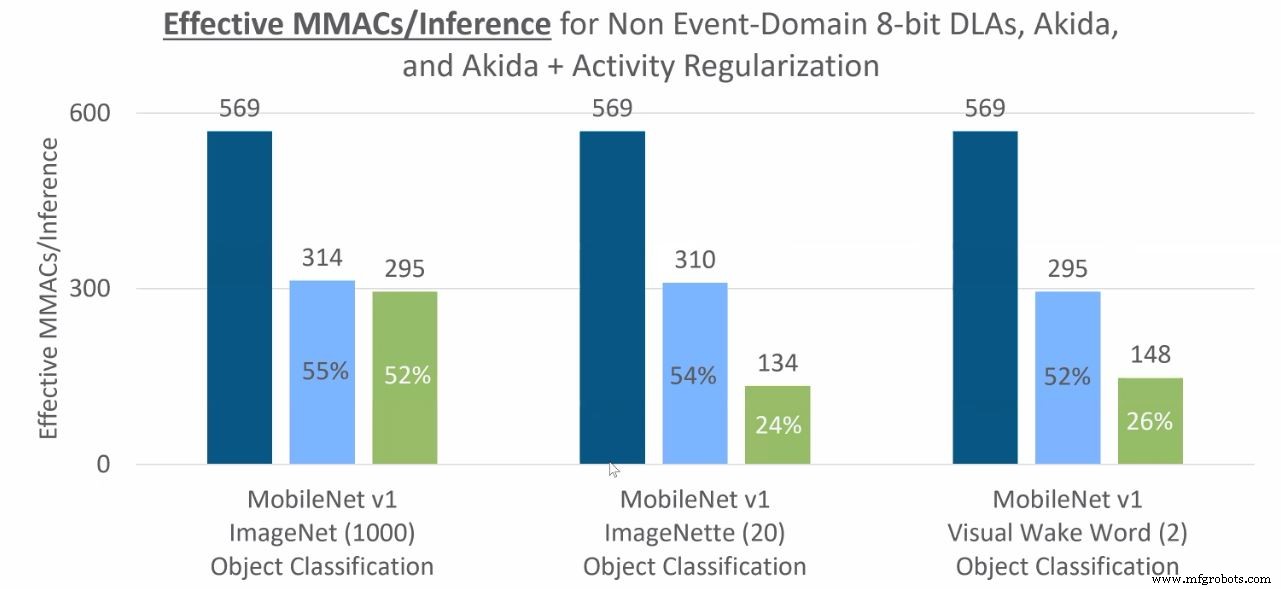
MAC-операции, требуемые для инференса классификации объектов (темно-синий — CNN в non-event домене, светло-синий — event домен/Akida, зеленый — event домен с дальнейшей регуляризацией активности). (Источник: BrainChip)
В реальном бенчмарке, keyword-spotting модель, запущенная на Akida плате после 4-битного квантования, потребовала всего 37 мкДж на инференс (эквивалентно 27 336 инференсов в секунду на ватт). Модель достигла 91,3% точности работая на скромных 5 МГц тактовой частоте.
Sensor Agnostic
NPU IP и Akida чип BrainChip network-agnostic и поддерживают широкий спектр сенсоров. Будь то обработка изображений, аудио, офлякторных, густаторных или тактильных данных, то же железо может обрабатывать как CNN (через конвертацию), так и нативные SNN.
Каждый NPU узел содержит 100 КБ локального SRAM для параметров, активаций и event буферов, и до четырех узлов могут быть кластеризованы в mesh-сеть. Сети, охватывающие множественные узлы, коммуницируют напрямую между слоями без CPU вмешательства, хотя определенные non-CNN нагрузки все еще требуют CPU поддержку. IP может масштабироваться до 20 узлов, позволяя большим моделям запускаться в множественных проходах на меньшем железе.
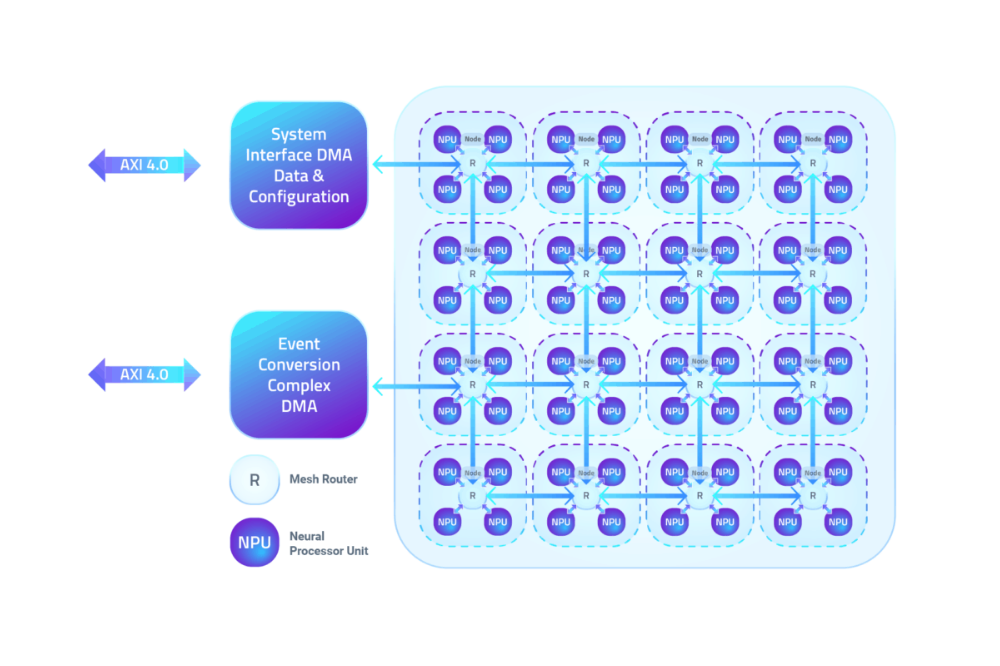
Узлы четырех BrainChip NPU соединены mesh-сетью. (Источник: BrainChip)
Демо-видео показало Akida в кабине автомобиля: один чип одновременно детектировал водителя, распознал лицо водителя и идентифицировал их голос. Keyword spotting требовал только 600 мкВт, распознавание лица 22 мВт, и visual wake-word инференс 6–8 мВт — демонстрируя пригодность чипа для автомобильного edge AI.
Роб Телсон, VP мировых продаж BrainChip, отметил, что 28-нм TSMC процесс Akida предоставляет сильную базу, и IP-клиенты могут перейти на более тонкие узлы для еще большей энергоэффективности. Он также подсветил on-chip обучение для распознавания лиц: с достаточными нейронами в финальном слое система может вырасти от распознавания 10 лиц до более 50 с one-shot обучением, устраняя облачную зависимость.
Ранние клиенты доступа
BrainChip нанимает 55 сотрудников по своим штаб-квартирам в Aliso Viejo, CA, и дизайн-офисам в Тулузе, Франция; Хайдарабад, Индия; и Перт, Австралия. Компания держит 14 патентов, торгуется на австралийской бирже и листирована на US OTC рынке.
Ранние-доступ клиенты включают NASA, авто, военные, аэрокосмические, медицинские (например, офлякторное COVID-19 детектирование) и потребительские электроники фирмы. Renesas лицензировала 2-узловый Akida NPU IP для интеграции в будущие микроконтроллерные единицы, нацеленные на анализ сенсорных данных в IoT развертываниях.
Akida IP и кремний доступны сейчас.
>> Эта статья была изначально опубликована на нашем сестринском сайте, EE Times.
Связанные материалы:
- Стартап упаковывает 1000 RISC-V ядер в AI ускорительный чип
- AI чип нацелен на низкоэнергопотребляющие пограничные устройства
- AI-enabled SoC обрабатывают множественные видеопотоки
- Строительство безопасности в AI SoC используя CPU фичи с расширениями
- Микроконтроллерные архитектуры эволюционируют для AI
Для большего Embedded, подпишитесь на еженедельную email-рассылку Embedded.
Встроенный
- Почему Linux движет облаком: исчерпывающее руководство
- 10 критичных преимуществ облачных вычислений для современного бизнеса
- Облачные вычисления или локальная инфраструктура: что лучше для вашего бизнеса?
- Event Flag Groups в Nucleus SE: Вводное руководство по конфигурации и использованию API
- Нейроморфные чипы: новая граница производительности AI
- Kontron представляет COM HPC: новый стандарт высокопроизводительных встроенных вычислений
- STMicroelectronics запускает $99 LoRa Development Kits для быстрого IoT развертывания
- RSL10 Mesh Development Kit усиливает ультра‑низкоэнергозатратные BLE‑сети
- ams представляет наборы NanoVision и NanoBerry на базе 1мм×1мм сенсора NanEyeC
- События в C#: Обработка пользовательских действий и системных уведомлений