



Аналоговые in-memory вычисления: энергоэффективный edge AI инференс
Машинное и глубокое обучение теперь вплетены в повседневные технологии. От естественно-языковых ассистентов до детекции объектов в реальном времени, AI движет растущим числом потребительских и промышленных устройств. Однако большинство этих приложений полагается на облачные инференс-движки — архитектура, поднимающая опасения по приватности, потреблению энергии, латентности и стоимости.
Развертывание AI локально на краю может устранить эти проблемы. Главный барьер — memory-driven power drain конвенциональных цифровых нейросетевых ускорителей. Когда веса и активации извлекаются из DRAM или SRAM, одно только перемещение данных потребляет два-три порядка больше энергии, чем сама арифметика. Аналоговые in-memory вычисления атакуют это узкое место, выполняя multiply-accumulate (MAC) операции прямо внутри массива невиолатильной памяти.
Облачный AI: болевые точки
Когда edge-устройство форвардит сырой данные на удаленный сервер, возникают несколько проблем:
- Приватность и безопасность — Персональная или конфиденциальная информация передается и хранится в дата-центрах.
- Лишнее потребление энергии — Каждый бит, посланный по радио, сохраненный в облаке и ре-достатый, сжигает энергию.
- Латентность для small-batch инференса — Ответы могут занимать более 100 мс, что воспринимается пользователями.
- Неэффективность data-экономики — Сенсоры генерируют массивные потоки; загрузка всего не экономична и не устойчива.
Для преодоления этих вызовов, обученная модель сначала строится на высокопроизводительной платформе (облако, GPU ферма и т.д.). Полученные веса затем маппятся на легкий инференс-движок, выполняющий вычисления локально.
MAC-тяжелая природа нейросетей
Даже легкие модели доминируют MACами. Например, MobileNet-v1 с входом 224×224 содержит 4.2 млн параметров и требует 569 млн MAC на инференс. Умножение и накопление выполняются в плоском матрично-векторном произведении.
Почему цифровые вычисления борются
В конвенциональном ускорителе веса и активации хранятся в DRAM/SRAM и должны быть фетчены в арифметико-логическое устройство (ALU). Рисунок 3 иллюстрирует память-узкое место: энергия, затраченная на перемещение данных (50–100 pJ на трансфер), кардинально превосходит 250 fJ на MAC операцию. Даже с агрессивными техниками реуза данных, фон Нейман архитектура накладывает жесткий лимит на энергоэффективность.
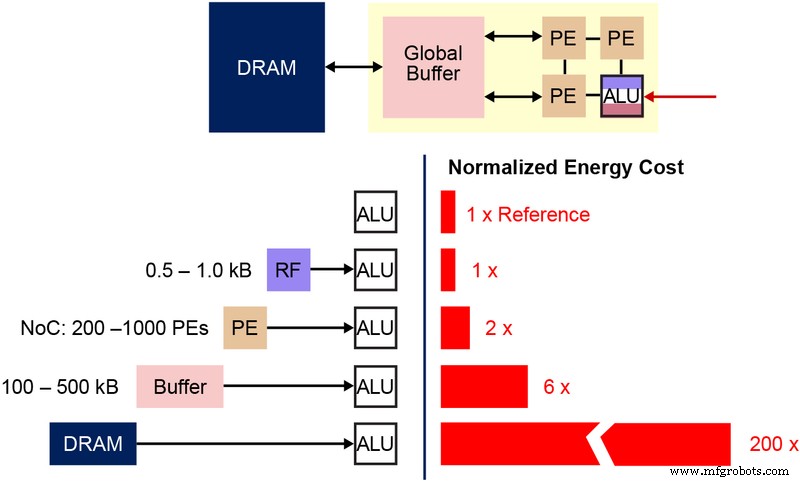 Рисунок 3: Memory Bottleneck в Machine Learning вычислениях. (Источник: Y.-H. Chen, J. Emer, and V. Sze, "Eyeriss: A Spatial Architecture for Energy-Efficient Dataflow for Convolutional Neural Networks," ISCA, 2016.)
Аналоговые in-memory вычисления на спасении
Встраивая вычисления в массив памяти, необходимость шаттлить веса исчезает. Оставшийся трансфер данных ограничен входным сигналом, который обычно — выход сенсора. Flash-ячейки, работающие в sub-threshold режиме, потребляют суб-наноамперные токи, делая активную мощность пренебрежимо малой. В standby невиолатильные ячейки удерживают данные без какого-либо потребления.
Платформа memBrain™ от Silicon Storage Technology (компания Microchip) примефицирует этот подход. Построенная на памяти SuperFlash® (ESF3), каждый битселл может быть запрограммирован на точное пороговое напряжение (Vt), устанавливая проводимость, представляющую вес. Когда входное напряжение приложено, ток через ячейку равен произведению входа и сохраненного веса.
Многоуровневая архитектура памяти
Рисунок 4 показывает поперечное сечение ESF3 битселла. Ячейка включает пять терминалов — Control Gate (CG), Word Line (WL), Erase Gate (EG), Source Line (SL) и Bitline (BL). Высоковольтный EG программирует плавающий гейт, в то время как низковольтное смещение на остальных терминалах читает или пишет ячейку.
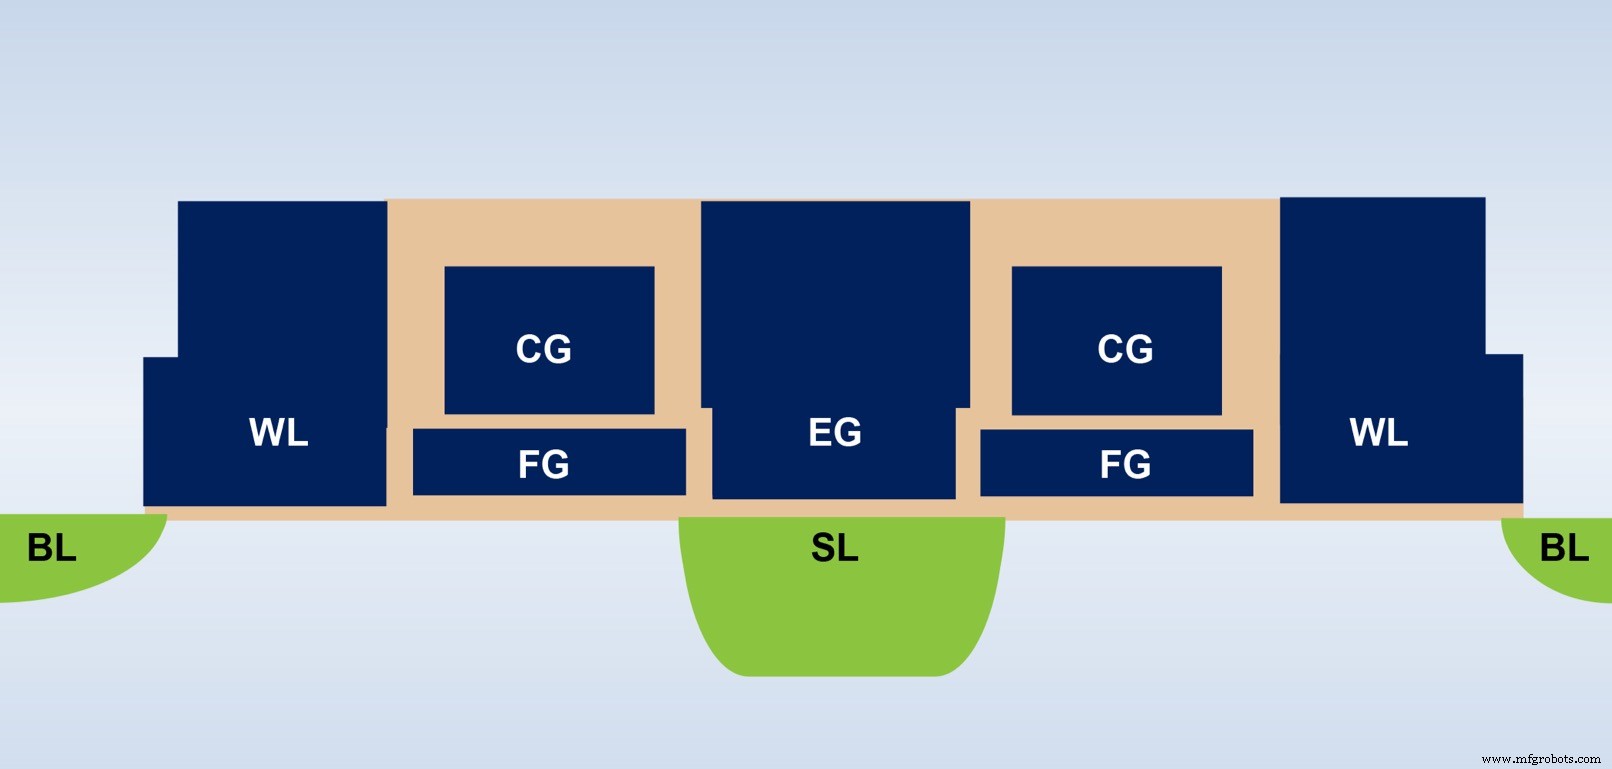 Рисунок 4: SuperFlash ESF3 Cell. (Источник: Microchip Technology)
Тонкая программировка настраивает Vt плавающего гейта для производства специфической I-V кривой. Рисунок 5 демонстрирует 2-битный пример, где четыре отдельных Vt уровня дают четыре отдельных тока отклика при фиксированном CG напряжении.
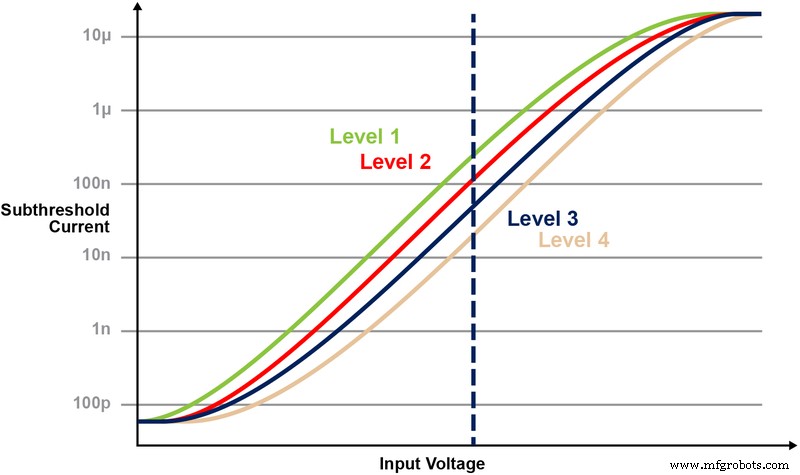 t Levels in ESF3 Cell" /> Рисунок 5: Программирование Vt уровней в ESF3 Cell. (Источник: Microchip Technology)
MAC в массиве памяти
Проводимость каждой ячейки gm воплощает обученный вес. Ток Iout = gm · Vin реализует шаг умножения. Соединяя многие ячейки параллельно, столбцовые токи естественно суммируются, давая операцию накопления. Рисунок 6 визуализирует 2×2 массив, выполняющий два MAC и одно накопление.
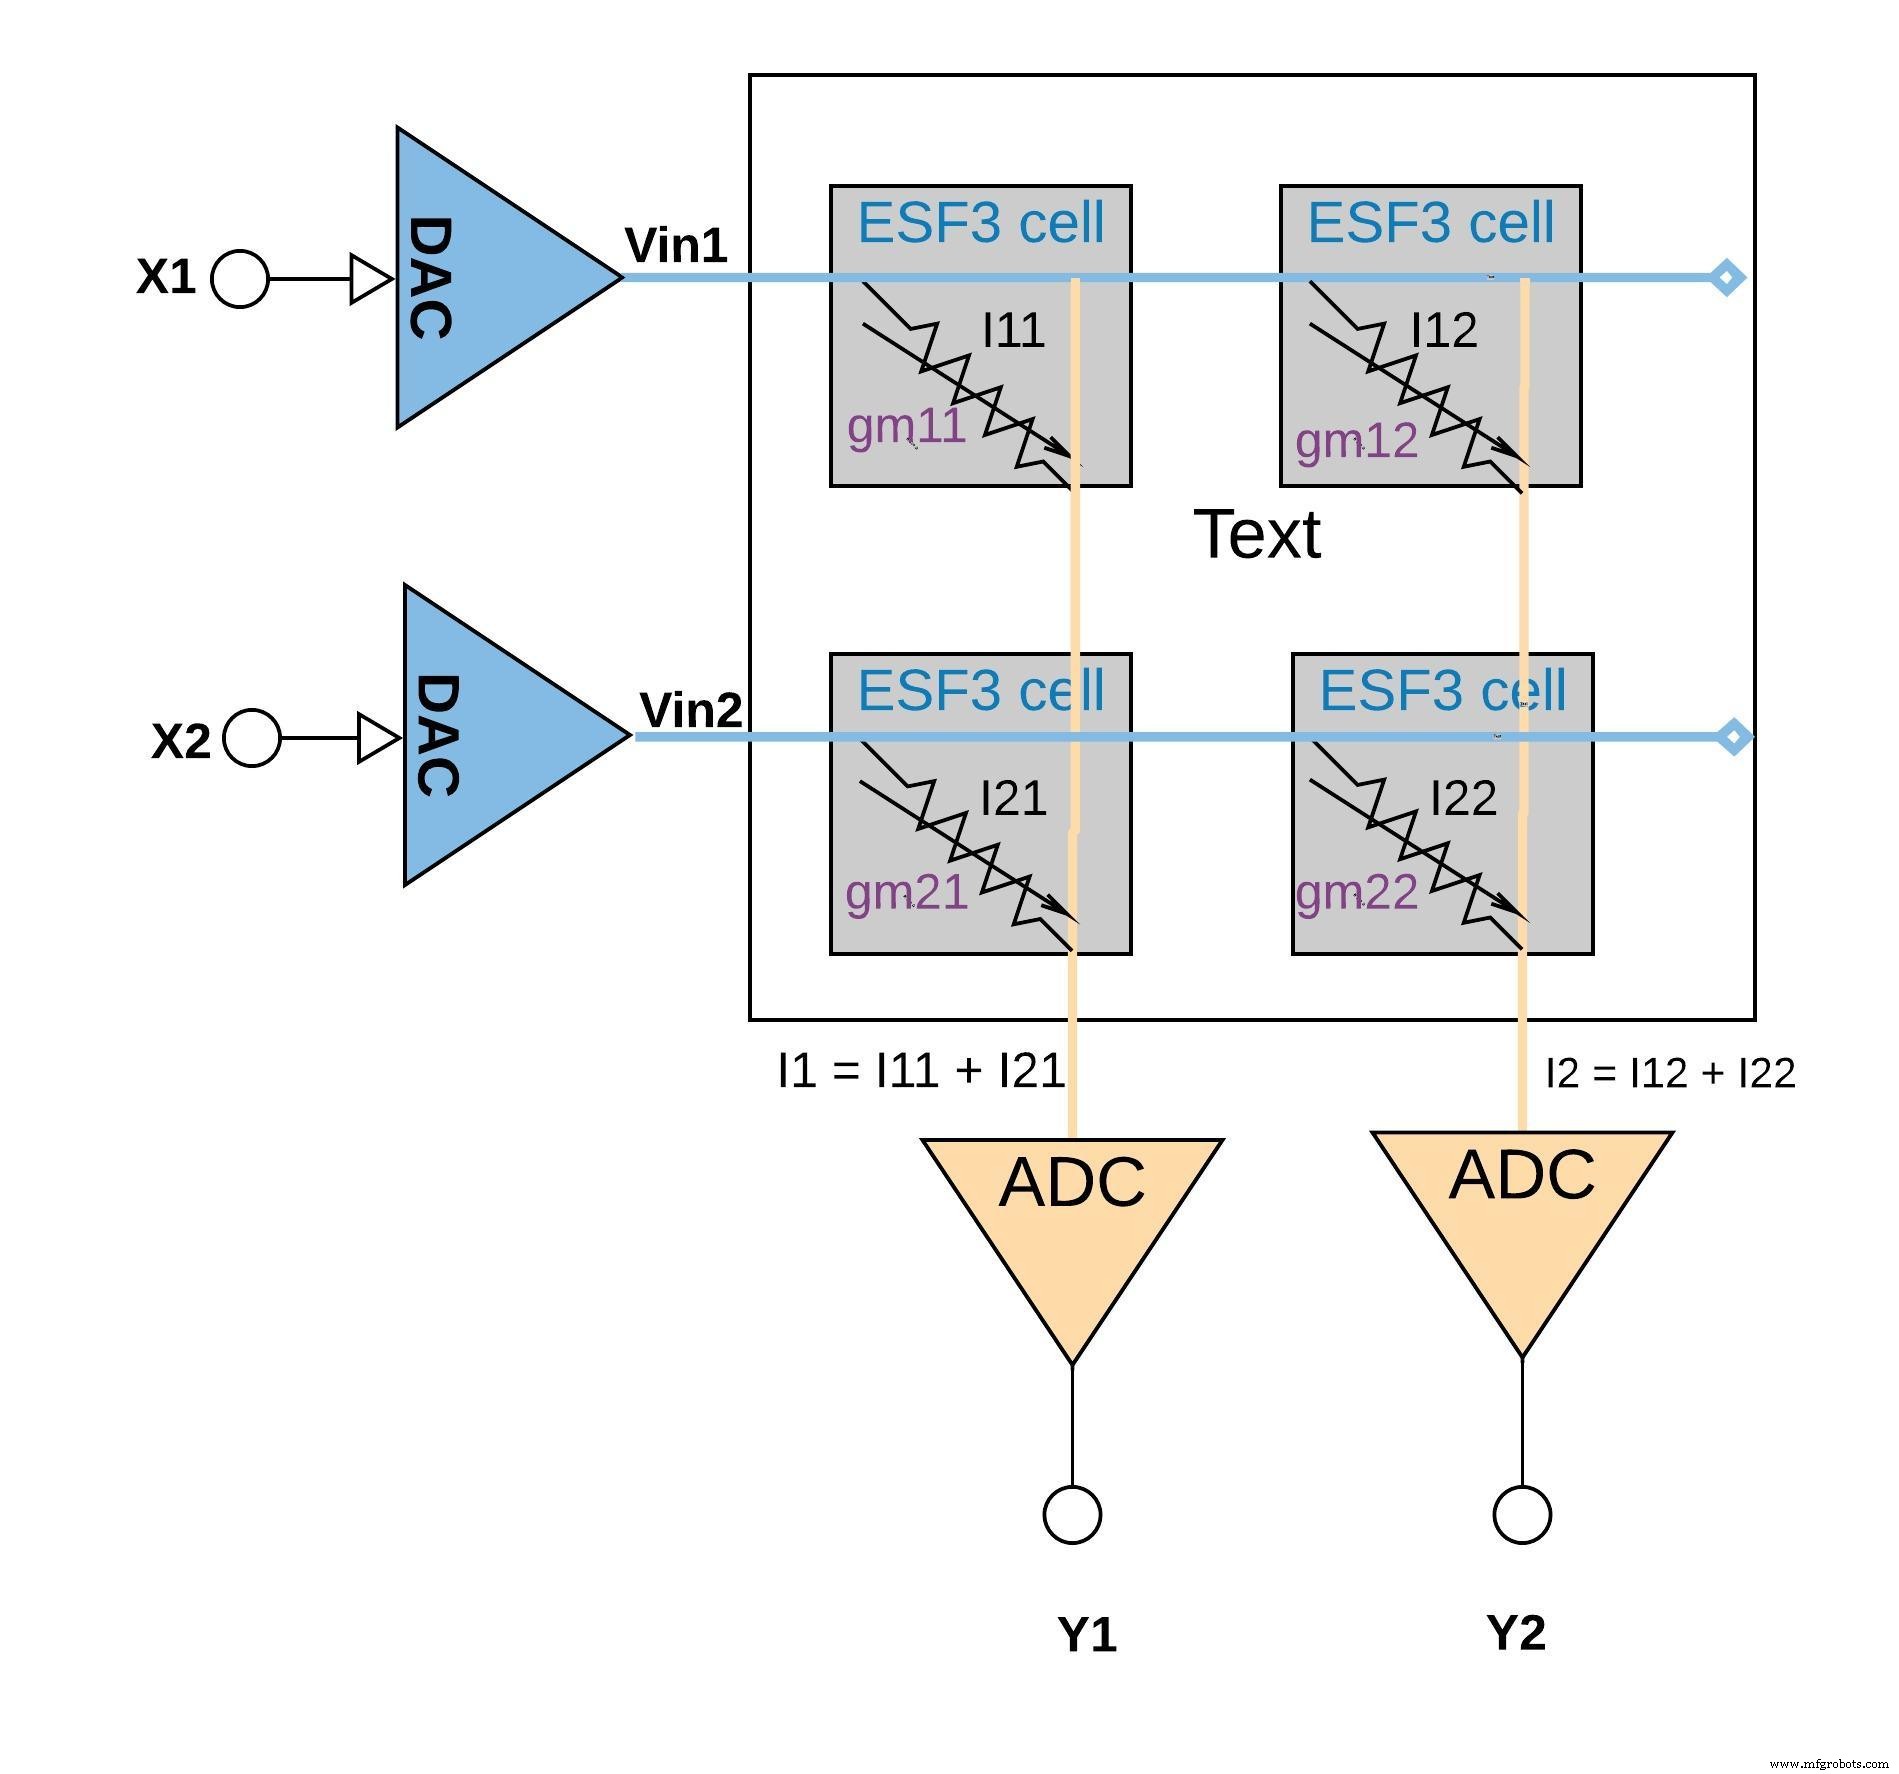 Рисунок 6: Multiply-Accumulate операция с ESF3 массивом (2×2). (Источник: Microchip Technology)
В большем масштабе, матрица весов может быть замаплена на единичный массив памяти. Рисунок 7 показывает матричную раскладку для fully connected слоя.
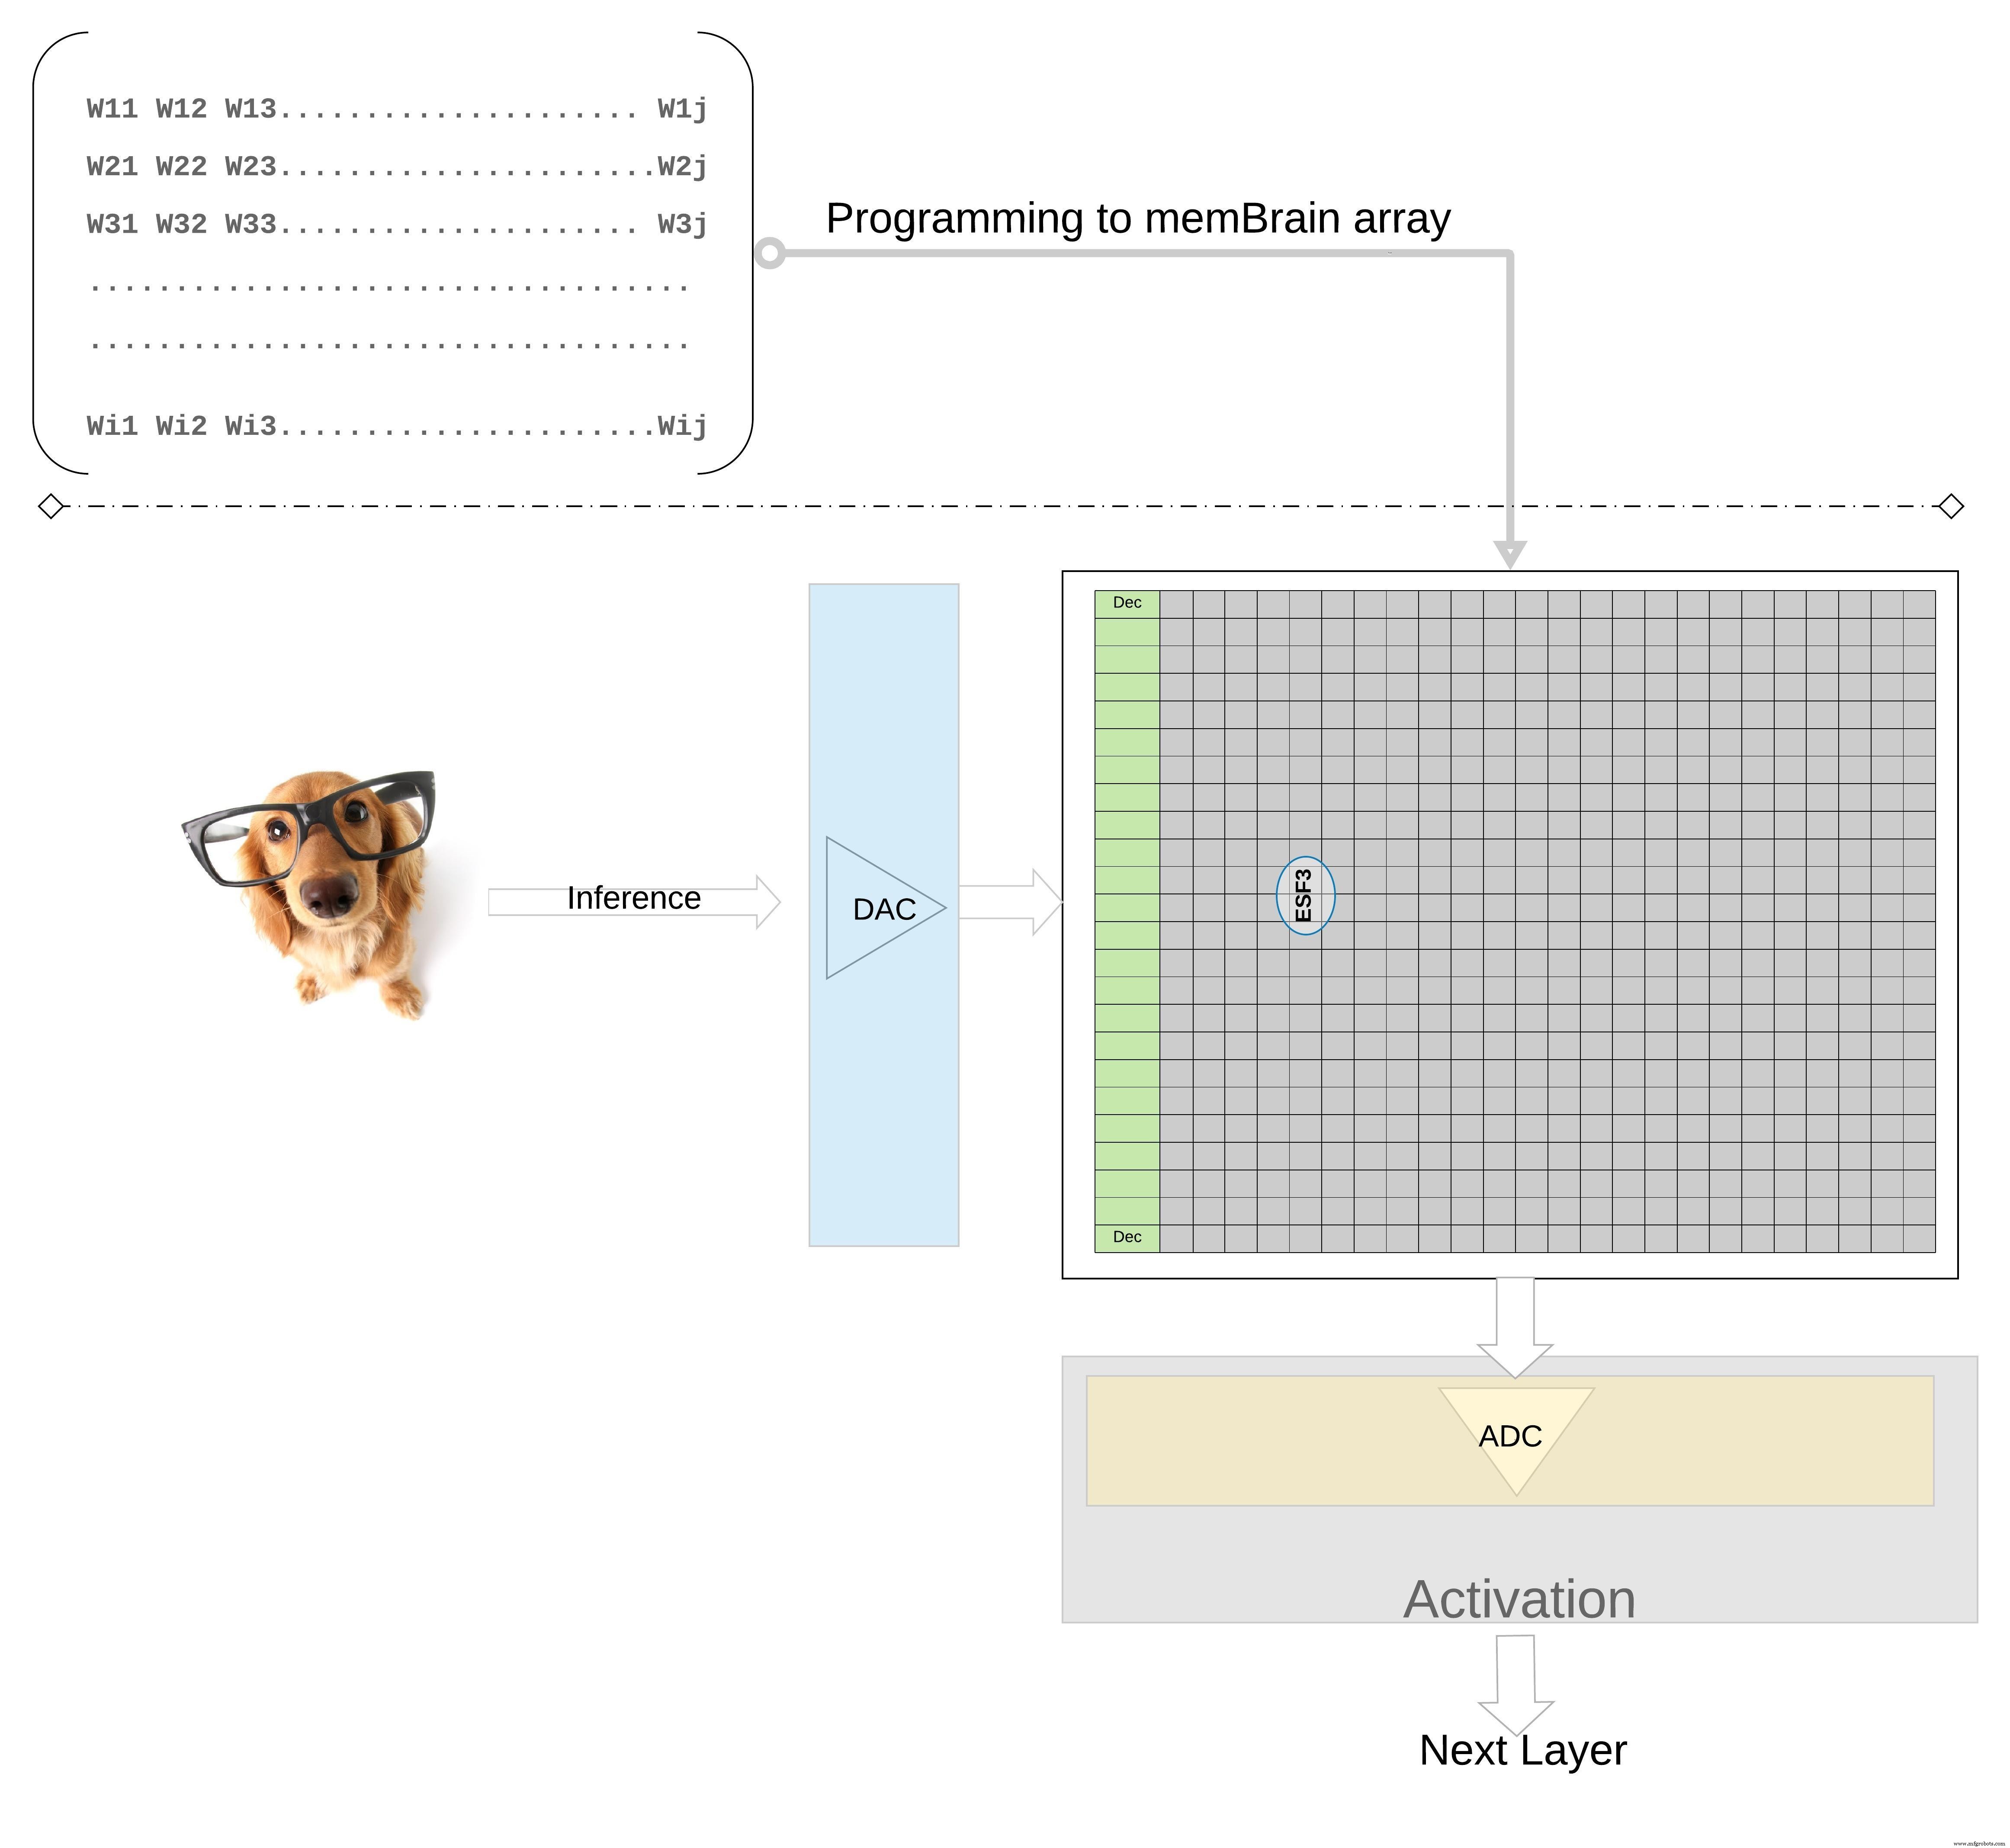 Рисунок 7: Weight Matrix Memory Array для инференса. (Источник: Microchip Technology)
Инференс-поток прямолинеен: сенсорные данные оцифровываются, конвертируются в аналоговое напряжение DAC, подаются в массив, и результирующие столбцовые токи оцифровываются ADC для последующих стадий активации и пулинга.
Модулярность и масштабируемость
memBrain тайлы спроектированы для стекинга. Рисунок 8 показывает 3×4 конфигурацию, где множественные тайлы делят общий аналого-цифровой интерконнект. Данные движутся через тайлы через общую шину, позволяя строить глубокие сети без единого монолитного дай.
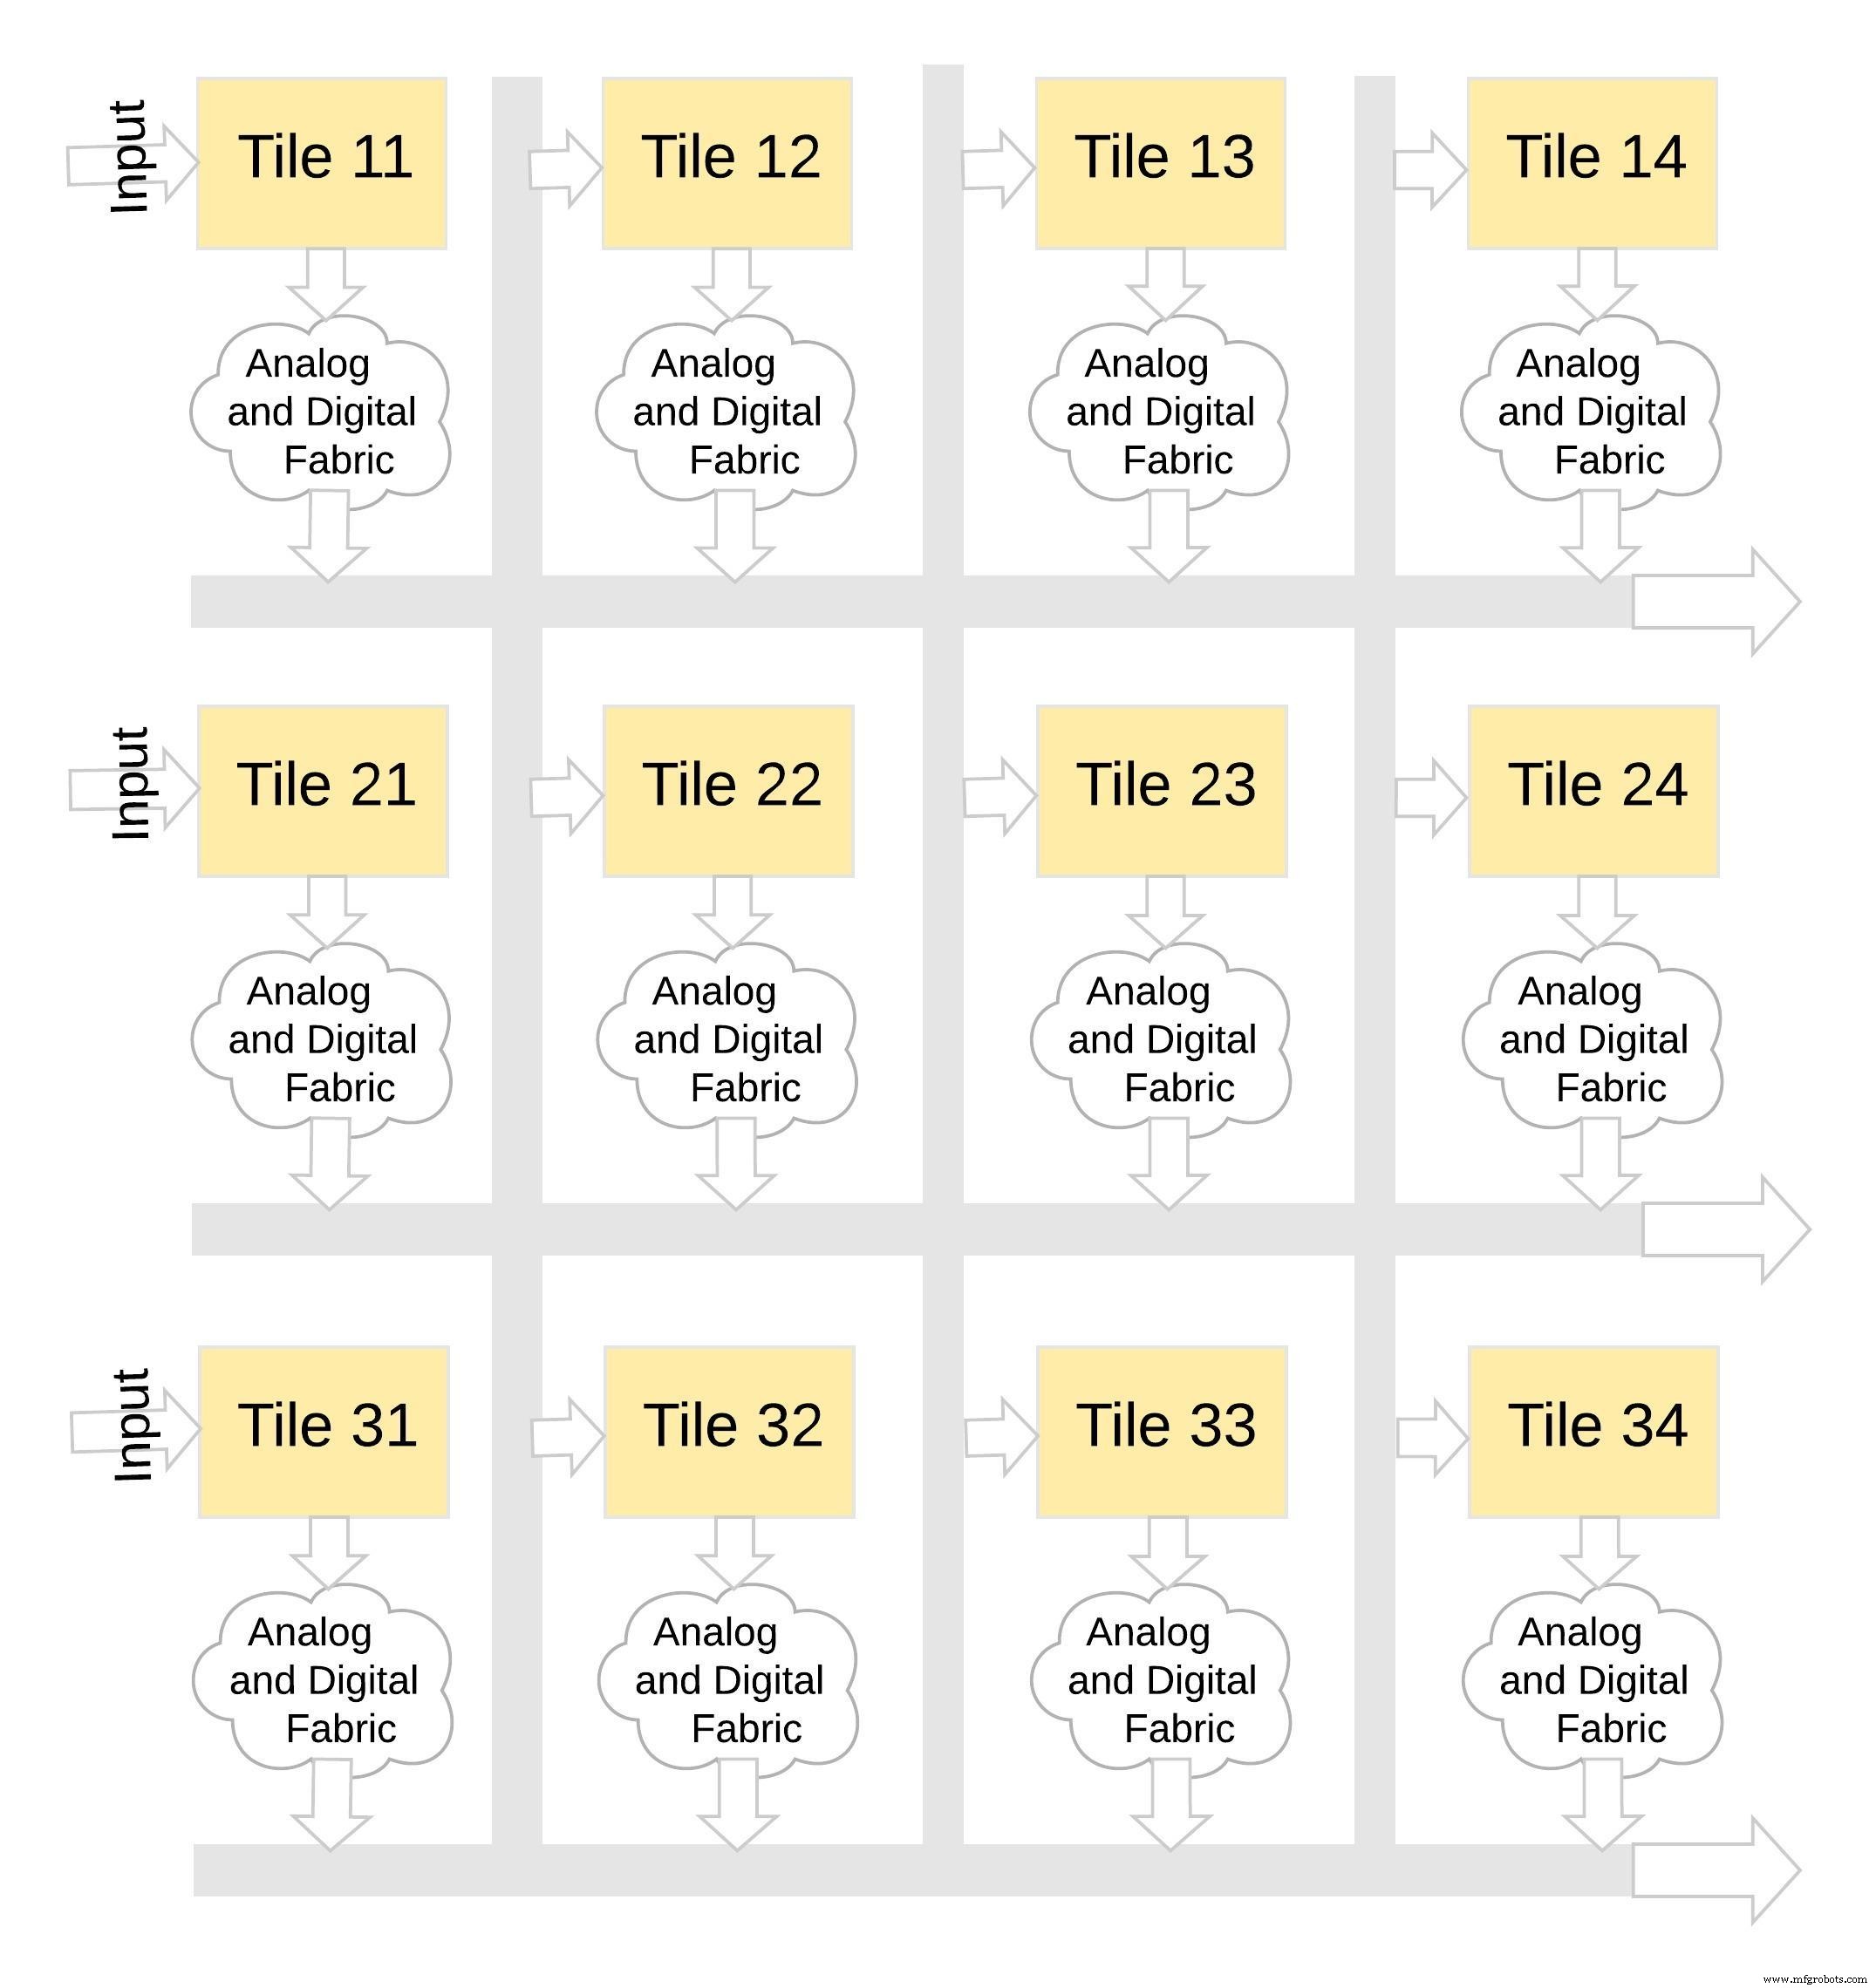 Рисунок 8: memBrain™ модулярен. (Источник: Microchip Technology)
Software Development Kit (SDK)
Сопутствующий SDK framework-agnostic. Независимо от того, тренируете вы в TensorFlow, PyTorch или другой библиотеке, SDK обрабатывает квантизацию модели, маппинг и деплой на memBrain железо. Рисунок 9 обводит workflow от тренировки к инференсу.
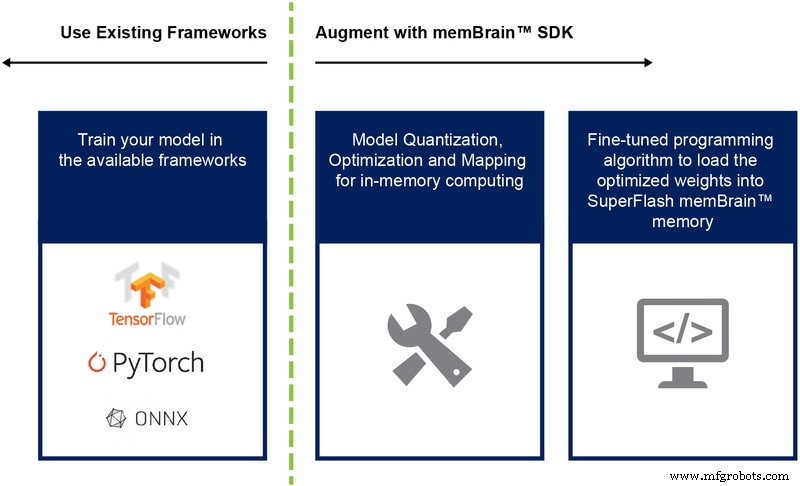 Рисунок 9: memBrain™ SDK Flow. (Источник: Microchip Technology)
Ключевые преимущества
- Ультра-низкое потребление — In-memory compute устраняет перемещение данных, flash-ячейки работают sub-threshold, и standby мощность не нужна. Архитектура также эксплуатирует sparsity, так как нулевые веса или входы оставляют ячейки idle.
- Компактный футпринт — 1.5-транзисторный split-gate битселл хранит 4-битное значение, тогда как 6-транзисторный SRAM потребовал бы 24 транзистора для тех же данных. Результат — драматично меньшая площадь дай.
- Сниженная стоимость разработки — Используя зрелые flash-процессы и избегая ультра-плотных геометрий, mask set затраты и лид-таймы значительно ниже по сравнению с ASIC для edge AI.
Edge AI обещает трансформационные приложения, но мощность и стоимость остаются лимитирующими факторами. Аналоговые in-memory вычисления, подкрепленные проверенной multi-level flash технологией, предлагают практичный, низкозатратный путь принести интеллектуальный инференс прямо к сенсору.
Встроенный
- Как Edge Computing может трансформировать Enterprise IT: сбалансированная перспектива
- Почему облачные вычисления уполномачивают IT-команды
- Пограничные вычисления (Edge Computing) разъяснены: практические кейсы в транспорте, энергетике и производстве
- Периферийные вычисления: 5 потенциальных подводных камней — и как их преодолеть
- Использование IIoT-данных для повышения рентабельности в lean manufacturing
- Edge Computing: катализатор, движущий Индустрию 4.0 вперед
- Как перебои с электричеством угрожают блокам питания — и как их защитить
- 6 веских причин внедрить периферийные вычисления
- Пограничные вычисления и 5G: драйверы трансформации предприятий
- Как малым производственным мастерским внедрять цифровые решения стоимостно-эффективно