



Понимание облачных сбоев: причины, влияние и предотвращение
Чем больше ИТ полагается на облачные сервисы, тем выше вероятность простоев и потерь выручки из-за облачных сбоев. Более 60% организаций, использующих публичное облако, сообщили о потерях в 2022 году из-за таких инцидентов, поэтому сбои — не редкость, с которой компании вряд ли столкнутся.
Но являются ли сбои достаточной причиной уйти из облака навсегда? Или стоит остаться на этой инфраструктуре несмотря на риск периодических простоев?
Эта статья охватывает все, что нужно знать об облачных сбоях. Мы разберем их главные причины, рассмотрим впечатляющую статистику, покажем, как минимизировать влияние облачного даунтайма, и посмотрим на самые значимые сбои последних лет.
Что такое облачный сбой (Cloud Outage)?
Облачный сбой — промежуток времени, в течение которого сервисы облачного провайдера недоступны конечным пользователям. Инфраструктура вендора выходит из строя (из-за бага, отключения питания и др.), и клиенты теряют доступ к облачным активам до устранения проблемы провайдером.
По влиянию нет разницы между выходом из строя локального дата-центра и облачным сбоем. В обоих случаях вы теряете доступ к ИТ-активам, но hands-off подход к облачным вычислениям добавляет уникальные соображения:
- Облачные сбои имеют мало или нулевую видимость причин, поэтому пользователи обычно не знают, что пошло не так.
- Команда провайдера отвечает за исправление ошибки, поэтому клиенты не участвуют в процессе восстановления.
- Поскольку у вас нет видимости или контроля над проблемой, невозможно узнать, когда сервисы вернутся онлайн.
Как и с локальным железом, есть два типа облачных сбоев:
- Плановые (обычно из-за планового обслуживания).
- Неплановые (происходят, когда провайдер сталкивается с неожиданной ошибкой и должен выполнять восстановительные меры).
Недавние исследования показывают, что неплановые сбои обходятся на 35% дороже планового даунтайма (и on-prem, и в облаке). Разница в цене существует, потому что непредвиденные инциденты дольше идентифицируются и исправляются — а чем дольше длится сбой, тем больше ущерб.
По сравнению с on-prem железом, облачная инфраструктура приводит к более частым простоям, но с меньшей тяжестью. Поскольку ни одна хостинг-система не обеспечивает 100% аптайма, клиенты готовы терпеть случайные сбои в обмен на преимущества облака. Эта готовность также видна в росте рынка — облако составит 14,2% от общих глобальных ИТ-расходов в 2024 году (вверх с 9,1% в 2020).
Причины облачных сбоев
Облачные сбои результатом ряда причин как в пределах контроля провайдера, так и за его пределами. Список самых частых:
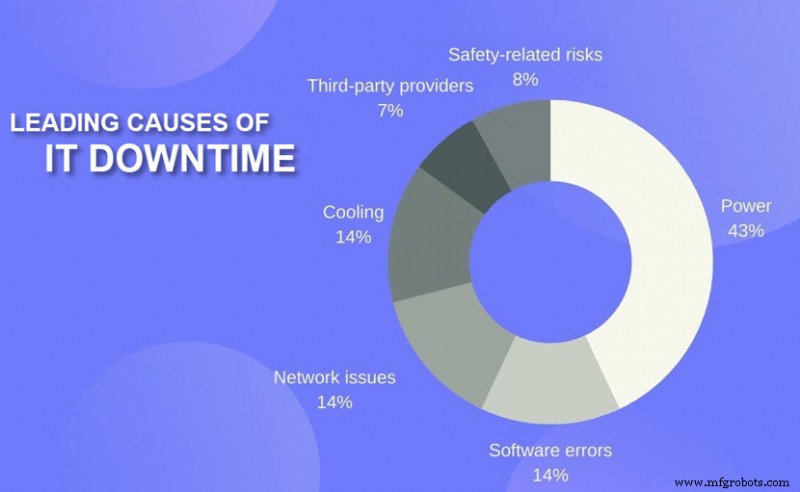
- Отключение питания: проблемы с питанием вызывают 43% всех облачных сбоев с значительным даунтаймом и финансовыми потерями. Отказы бесперебойников (UPS) — №1 причина инцидентов с питанием.
- Кибербезопасность: кибератаки вроде DDoS перегружают дата-центры входящим трафиком. Пользователи не могут получить доступ к сервису через ту же сетевую инфраструктуру. Другие угрозы (ransomware, SQL-инъекции) могут заставить провайдера отключить сервисы и устранять проблему офлайн.
- Человеческий фактор: одна неверная команда или ошибка с кабелями может уронить всю ИТ-инфраструктуру. Ошибки людей вызывают как физические, так и программные проблемы, ведущие к сбоям.
- Технические проблемы: облачные сервисы полагаются на сложную систему железа, поэтому ошибка, достаточно долго остававшаяся незамеченной, может привести к сбою.
- Баги ПО: глюки и баги часты в облачных дата-центрах. Обычные виновники: баги форматов данных, fault-related баги, timing bugs, constant value bugs.
- Сетевые проблемы: проблемы, связанные с сетевой коммуникацией и сторонними telco-партнерами — еще одна частая причина.
- Обслуживание: плановое обслуживание и апгрейды иногда ведут к сбою, хотя пользователи обычно знают об этом заранее.
- Экологические причины: ураганы, пожары, грозы, землетрясения также вызывают даунтайм, ставя под угрозу объект или повреждая региональную энергосеть.
- Более сложные развертывания: более сложные модели развертывания (гибридные, распределенные, мультиоблако) усложняют операции дата-центра, создавая больше возможностей для ошибок.
Что происходит, когда облако падает?
В лучшем случае сбой длится несколько минут и затрагивает мало пользователей или сервисов. В худшем — сбой парализует бизнес клиента на полдня или дольше. Компания теряет доступ ко всем облачным активам и остается отключенной до конца сбоя.
Хотя это угрожающе, ошибки сторонних провайдеров были причиной «всего» 7% тяжелых сбоев в 2021 году. Тяжелый сбой должен включать одно (или несколько) из:
- Значительных финансовых потерь.
- Репутационного ущерба.
- Нарушений комплаенса.
- Потери жизней.
Хотя есть более насущные проблемы (как показано на диаграмме ниже), помните, что средняя минута даунтайма стоит $5 600 (для энтерпрайзов — $9 000). Если вы неподготовлены (нет бэкапов, disaster recovery и др.), облачный сбой может остановить сервис и нанести массивные удары по итогам.
Компания, держащая в облаке небольшой сегмент операций, менее уязвима к сбоям. Например, если вы хостите только почту в облаке, даже суточный сбой не катастрофичен. Можно переждать инцидент или запускать приложения с уменьшенной функциональностью — стратегия не работает, если вы используете облако для IoT-платформы или обработки платежей.
В некоторых случаях облачный сбой приводит к необратимой потере данных (объем зависит от частоты бэкапов). Клиенты в строгих отраслях несут юридическую ответственность, если сбой приводит к утечке или нарушению данных, поэтому будьте осторожны, решая, что хранить в облаке.
Что могут сделать пользователи?
Вот что компании делают для смягчения влияния облачных сбоев:
- Устранение единых точек отказа (SPOF): подготовьте бэкап каждой миссионно-критичной ИТ-компоненты, либо в on-prem серверной, либо у вторичного провайдера. Если облако падает, выполняйте failover (переключение на резервный сервер, компонент, сеть и др.) для обеспечения бизнес-непрерывности.
- Имейте план действий на случай ЧС: план аварийного восстановления описывает пошаговую стратегию действий команды в случае сбоя. План дает инструкции по защите данных, выполнению failover, обеспечению непрерывности бизнеса и восстановлению операций. Своевременное планирование избегает потери времени на оценку лучшего курса действий во время даунтайма.
- Инвестируйте в SLA с более высокой доступностью: если бизнес-критичные задачи не могут позволить длительные сбои, ищите SLA с более высокой доступностью, например, гарантирующим 99,999% аптайма (максимум 5,25 минут даунтайма в год). Эти контракты дороже, но поддержание сервисов онлайн становится большим приоритетом для провайдера.
- Выполняйте регулярные бэкапы данных: бэкап гарантирует способность восстановить недавнюю версию файлов, если сбой повредит или удалит базу. Идеально — бэкапы автоматические, от раз в час до раз в день (в зависимости от критичности).
- Обнаруживайте сбои ASAP: любые дополнительные возможности облачного мониторинга, настроенные вашей командой, помогают идентифицировать сбой в реальном времени вместо ожидания уведомления провайдера. Вот список лучших инструментов облачного мониторинга для улучшения детекции даунтайма и обеспечения своевременного failover.
Крупнейшие недавние облачные сбои
Облачные сбои неизбежны при использовании облака, и даже самые популярные провайдеры (Azure, AWS, Google Cloud) не иммунны к даунтайму. Посмотрим на самые значимые сбои недавней истории.
Сбой Azure (октябрь 2021)
В октябре 2021 Microsoft Azure столкнулся с нарушением, отключившим сервисы виртуальных машин на шесть часов. В течение сбоя многие пользователи не могли развертывать новые VM или обновлять расширения. Базовые операции управления сервисом (запуск, создание, удаление) также приводили к ошибкам.
Причина — неспособность VM-запросов получить необходимые данные версии артефакта. Пост-рекавери отчет показал, что программная ошибка произошла при миграции одной из VM-архитектур Microsoft.
Сбой Google Cloud (ноябрь 2021)
Google Cloud был вдауне около двух часов в середине ноября, затрагивая:
- Home Depot.
- Snapchat.
- Etsy.
- Discord.
- Spotify.
Затронутые сайты показывали ошибки 404 при попытке доступа. Google сообщил, что причина — глюк в сетевой конфигурации, отвечающей за балансировку нагрузки.
Сбой AWS (декабрь 2021)
Большой всплеск соединений перегрузил сетевые устройства в одном из флагманских объектов AWS, затрагивая различные сайты и приложения. Наиболее известные «жертвы»:
- Сайт Amazon.
- Prime Video.
- Netflix.
- IMDb.
- PlayStation Network.
Проблема дата-центра вызвала сильную латентность внутри внутренних сетей AWS. Клиентские приложения почувствовали волновой эффект, страдая от задержек трафика или полных отключений около семи часов.
Два последующих сбоя IBM (январь 2022)
Проблема с инфраструктурой IBM затрагивала облачные сервисы в регионе Далласа более пяти часов. Внутренняя команда решила проблему, но случайно вызвала дополнительный часовой сбой виртуального приватного облака. Вторичная проблема затронула пользователей по всему миру, включая США, Японию, Канаду и Германию.
Сбой AWS/Slack (февраль 2022)
Slack пострадал от сбоя AWS облачных ресурсов в феврале, препятствовав нормальному использованию платформы связи на пять часов. Более 11 000 пользователей не могли:
- Отправлять или получать сообщения.
- Загружать файлы.
- Присоединяться к каналам.
- Запускать десктопное приложение.
Команда Slack никогда не раскрывала причину сбоя и просила всех затронутых перезапустить приложение и очистить кэш после восстановления.
Сбой iCloud (март 2022)
Пятнадцать крупных сервисов Apple упали на четыре часа в марте из-за облачного сбоя, включая:
- App Store.
- Apple Maps.
- Apple TV.
Корпоративные и ритейловые системы Apple тоже упали. Компания позже раскрыла, что корневая причина — проблема с системой доменных имен (DNS).
Сбой Google Cloud (март 2022)
8 марта 2022 пользователи Google Cloud страдали от ошибок сервисов два с половиной часа. Spotify и Discord были среди пострадавших.
Изменение кода Traffic Director для обработки конфигураций вызвало ошибку. По пост-рекавери отчету, плохие изменения кода игнорировали миграции форматов данных конфигурации, поэтому платформа нечаянно удалила программирование пользователя.
Сбой Atlassian (апрель 2022)
Крупнейший сбой Atlassian года начался 5 апреля и закончился 18 апреля (хотя некоторые пользователи начали восстанавливать сервисы к 8 апреля). Компания объяснила, что сбой произошел из-за неадекватной командной коммуникации и плохо спланированного плана реагирования на инцидент.
Хотя этот сбой длился почти две недели для некоторых пользователей, не было отчетов о значительной потере клиентских данных. Однако пользователи обоих флагманских продуктов, Trello и Jira, были затронуты.
Сбой Microsoft Azure (июнь 2022)
7 июня клиенты Azure не могли подключиться к ресурсам, хостящимся в регионе East US 2 (в основном Вирджиния). Сбой длился около двенадцати часов и не затрагивал потребителей, полагающихся на zone-redundant инфраструктуру. Скомпрометированные сервисы:
- Application Insights.
- Log Analytics.
- Managed Identity Service.
- Media Services.
- NetApp Files.
Виновик — внезапная колебательность питания в одном из локальных дата-центров, вызвавшая отключение Air Handling Units (AHU).
Сбой Cloudflare (июнь 2022)
В июне случайный сбой в Cloudflare вызвал крупные нарушения, длившиеся полтора часа, уронив популярные сайты вроде:
- Discord.
- Shopify.
- Fitbit.
- Peloton.
Вендор из Сан-Франциско объяснил, что неплановый даунтайм результатом изменения сетевой конфигурации в 19 своих дата-центров.
Не недооценивайте ценность планирования облачных сбоев
Примеры облачных сбоев последних лет посылают четкое сообщение: даже если облако — гейм-чейнджер в ИТ, технология не безупречна. Компаниям, заботящимся о пользователях и доступности приложений, нужно быть готовыми к периодическому даунтайму, что делает backup и disaster recovery (BDR) неотъемлемой частью использования облачных ресурсов.
Облачные вычисления
- Трансферная литье: процесс, преимущества и варианты
- Бенчмаркинг производительности публичного облака: Почему это важно и как делать
- Понимание облачной безопасности: почему вашему бизнесу это нужно
- Облачная революция: как облачные вычисления трансформируют IT, безопасность и карьеры
- Безагентная и агентная архитектуры: выбор правильной модели облачной безопасности
- Понимание обфусцированных VPN‑серверов: как они работают и почему это важно
- Как работает Google Cloud Storage: полное руководство
- Освоение аудита вакуумных систем: почему это важно и как проводить
- Понимание промышленных сцеплений: определение, функция и применение
- Протоколы осмотра кранов: сроки, важность и лучшие практики