



Как продвинутая обработка сигналов обеспечивает бесшовное взаимодействие с голосовыми ассистентами
Умные колонки и голосовые устройства быстро расширяют охват, а ассистенты вроде Amazon Alexa и Google Assistant с каждым обновлением лучше расшифровывают наши речевые команды.
Одно из главных привлечений этого интерфейса — его бесшовная природа: никакой кривой обучения, просто естественный разговор. За этим гладким опытом стоит изощренная цепочка шагов обработки сигналов, превращающая сырой аудио в четкий, действие-ориентированный запрос.
В этой статье мы исследуем архитектуру, питающую голосовые решения, раскрывая скрытые слои железа и софта, оживляющие их.
Поток сигналов и архитектура
Хотя специфики варьируются по продуктам, фундаментальный поток консистентен. Используя умную колонку вроде Amazon Echo как пример, ключевые подсистемы иллюстрированы на Рисунке 1.
click for larger image
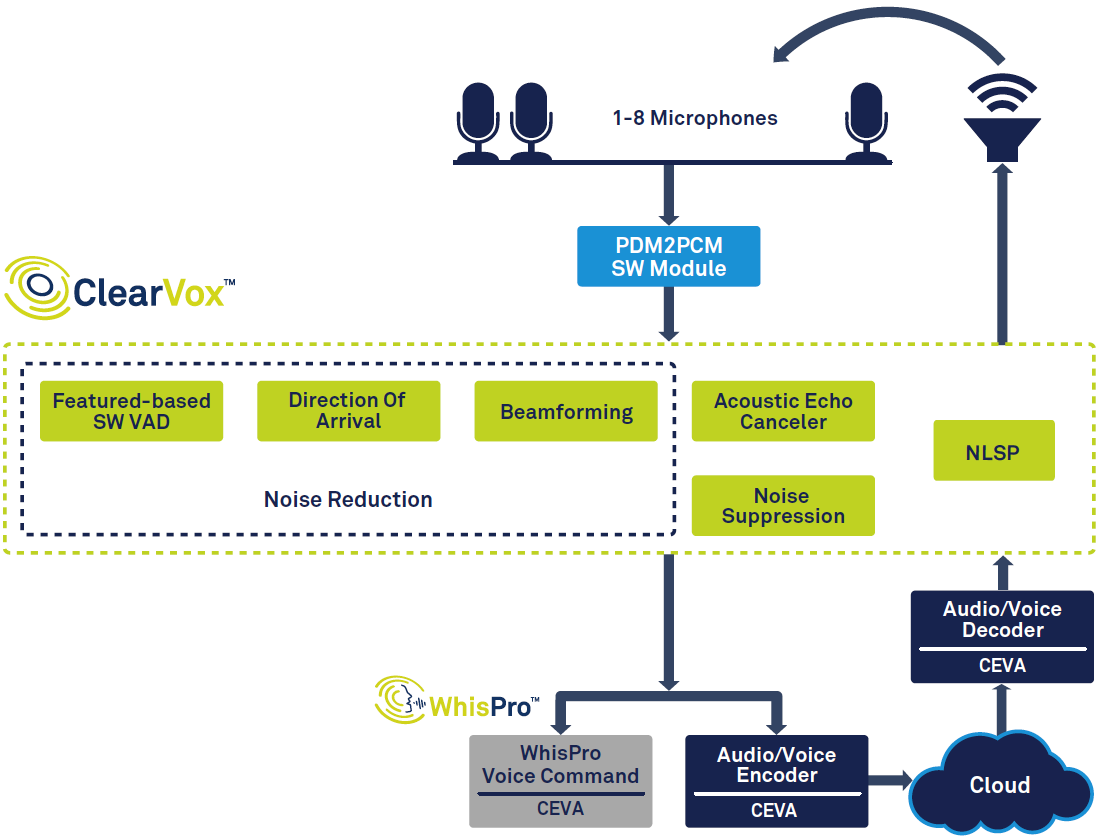
Рисунок 1: Цепочка сигналов для голосового ассистента, основанная на CEVA ClearVox и WhisPro. (Источник: CEVA)
Цепочка начинается с детекции голосовой активности (VAD), изолирующей речевые сегменты. Захваченный аудио оцифровывается и подвергается серии front-end алгоритмов, улучшающих четкость фокусировкой на направлении прибытия пользователя. Обработанный сигнал затем передается в back-end речевую обработку, которая может выполняться частично на устройстве (edge) и частично в облаке. Наконец, ответ — текст или речь — синтезируется, декодируется и рендерится через цифро-аналоговый путь колонки.
Разные кейсы вводят вариации. Например, in-vehicle голосовые интерфейсы должны справляться с дорожным шумом, тогда как возникающие носимые устройства требуют ультра-низкого потребления и минимальной стоимости.
Front-end обработка сигналов
После VAD и оцифровки устройство должно подавить нежелательные звуки. Акустическая эхо-отмена (AEC) удаляет отражения, вызванные собственным воспроизведением устройства, позволяя бесшовное «barge-in» даже пока играет музыка. Шумоподавление затем чистит остаточный фоновый шум.
Голосовые устройства делятся на две категории: near-field (хедсеты, наушники) и far-field (умные колонки, ТВ). Near-field единицы обычно используют один или два микрофона, тогда как far-field развертывают три до восьми микрофонов. Последние сталкиваются с более суровой акустической средой — голоса затухают с расстоянием, фоновый шум остается постоянным, и реверберация усложняет извлечение сигнала.
Far-field единицы используют beamforming (лучеобразование), технику, вычисляющую направление источника из разниц во времени по микрофонам. Это позволяет системе фокусироваться на пользователе, игнорировать отражения, трекать движение и изолировать одного спикера при множестве голосов.
Детекция триггер-слова (напр., «Алиса») — критичная фича. Непрерывное прослушивание поднимает вопросы приватности; поэтому многие системы выполняют распознавание wake-word локально, отправляя аудио в облако только после детекции полной команды.
Очищенный голосовой сэмпл кодируется перед передачей в облачный бэкенд для глубокого анализа.
Специализированные решения
Front-end обработка должна быть быстрой, точной и энергоэффективной — особенно для батарейных носимых. Универсальные DSP или CPU борются с этими требованиями по стоимости, размеру и энергопотреблению. Решение — application-specific DSP, спроектированный для аудио-задач.
ClearVox от CEVA — программный набор, обрабатывающий multi-mic beamforming, оценку направления прибытия, шумоподавление и AEC по разным акустическим сценариям. Оптимизированный для CEVA sound DSP, ClearVox дает низкозатратный, малоэнергопотребляющий путь к качественному захвату голоса.
Детекция триггер-слова обрабатывается WhisPro от CEVA — нейросетевым рекогнайзером, эксклюзивным для CEVA DSP. WhisPro держит главный процессор спящим до детекции wake-word, резко снижая общую системную мощность при сохранении >95% recognition rate. Поддерживает множество триггер-фраз и кастомных слов — критический фактор для удовлетворенности потребителей.
click for larger image
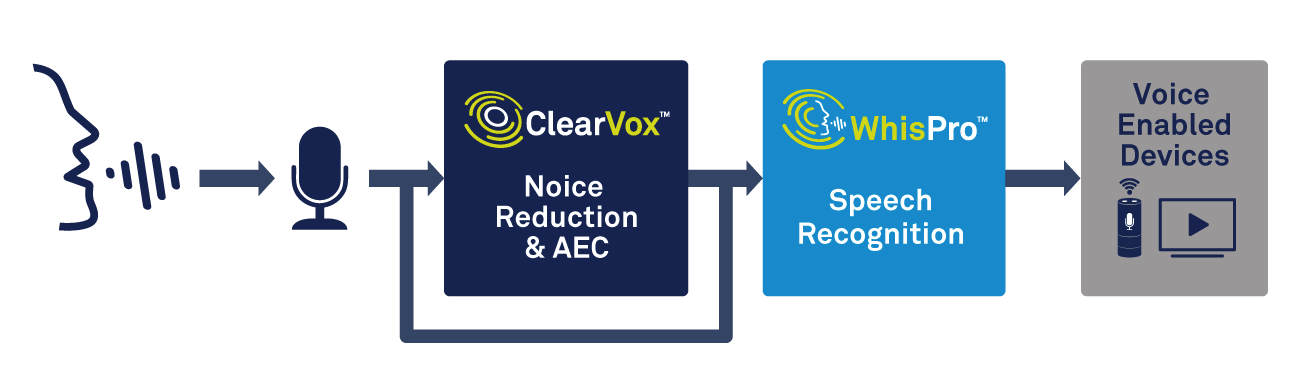
Рисунок 2: Использование голосовой обработки и распознавания речи для голосовой активации. (Источник: CEVA)
Распознавание речи: локальное или облачное
Когда аудио чисто и оцифровано, следующий шаг — автоматическое распознавание речи (ASR). Спектр идет от простого keyword spotting до полноценной natural-language processing (NLP). Keyword detection идеален для узкоспециализированных устройств (напр., умный термостат), позволяя офлайн, мгновенные ответы.
Наоборот, многие приложения требуют контекстуального понимания. Запрос вроде «Покажи хороший отель с хорошим соотношением цена/качество у центра города» должен быть разобран на намерение, сущности и контекст follow-up — работа, требующая нейросетевого инференса далеко за пределами возможностей низкопотребляющих edge-чипов.
Облачная обработка дает вычислительный ресурс для сложного NLP, ценой латентности и зависимости от интернета. Edge решения улучшаются; NeuPro AI процессоры CEVA приносят on-device нейросетевой инференс на край, позволяя умные, быстрые локальные ответы с фоллбэком в облако при необходимости.
Выбор между edge и облаком включает компромиссы. Локальная обработка выигрывает в скорости и приватности, но борется со сложными запросами. Облачная масштабируется к сложному NLP, но вводит латентность и зависимость от коннективности.
Заключение
Голосовые интерфейсы быстро становятся краеугольным камнем повседневной технологии. Непрерывные прогресс в обработке сигналов, ASR и ИИ — в связке со специализированным железом — движут высокую точность, низкое потребление и сниженные затраты.
OEM, принимающие purpose-built решения вроде ClearVox, WhisPro и NeuPro, могут встретить строгие цели производительности, стоимости и мощности, сокращая time-to-market.
По мере зрелости голосовой технологии мы можем ждать еще более естественного взаимодействия и более широких горизонтов применения — увлекательное путешествие, которое переформирует то, как мы'engage' с устройствами.
Встроенный
- Как новые edge AI и микрофоны ускоряют принятие голосовых ассистентов
- Полное руководство по производству стекловолокна
- Оптимизируйте свою цепочку поставок для устойчивости и эффективности сегодня
- Как работают SCADA-системы: мониторинг и контроль промышленных процессов
- Цифровой компас в реальном времени на Arduino и Processing
- Создайте выигрывающий прототип: Пошаговое руководство для быстрой разработки продукта
- Как работают воздухосушители: поддержание сжатого воздуха чистым и эффективным
- Струйно-печатный графен: Будущее 3D-печатной электроники
- Электрические тормоза: принцип работы, устройство и значение для безопасности
- Проверенные стратегии для работы комплексной программы безопасности