



Расчет скрытых затрат проблем производительности приложений и сети
Многие проспекты и клиенты удивляются, обнаруживая, насколько комплексной может быть инфраструктурная мониторинг. Сегодняшняя среда — облачные провайдеры, SaaS приложения, удаленные офисы и tech-savvy распределенные команды — создает сложную ткань, которая может чувствовать overwhelming. Неудивительно, что мониторинг всего стека может казаться невозможным; IT-команды все еще учатся управлять растущим массивом инструментов и пользователей.
Когда проблемы производительности всплывают, они обычно ловятся только после того, как пользователи сабмитят тикеты за медленные приложения, Wi-Fi глюки или рекуррентные таск фейлоры. IT тогда ныряет в траблшутинг, часто со смешанными результатами. Root-cause discovery становится реактивным упражнением, гонясь за неуловимыми «ghost» проблемами задолго после того, как пользователь уже задеван — подход, похожий на закрытие двери амбара после того, как лошадь уже сбежала.
И для IT, и для бизнеса, эти пользовательские фрустрации — больше чем annoyance. Сетевые и приложения замедления транслируются в реальные финансовые потери. Рассмотрите 300-персонную организацию, полагающуюся на G Suite или Office 365. Со средней часовой зарплатой $25 на пользователя, каждый час, когда сотрудники не могут acceder к приложению, стоит компании примерно $7 500. Недавний опрос нашел, что 98% организаций верят, что один час даунтайма стоит более $100 000, и 33% репортят, что один час даунтайма стоит между $1 млн и $5 млн.
Что проблемы производительности стоят вашему бизнесу
Исторически, даунтайм был главным concern. Сегодня, однако, приложения спроектированы для высокой доступности; реальная угроза — sluggish производительность. Пользователи жалуются больше о приложении, висящем на задаче или тратящем слишком много времени на загрузку, чем о прямом аутэйдже. Многие производительностные хиккапы интермитирующие и трудно воспроизводимые, часто всплывающие как вялые «Wi-Fi проблемы».
Исследование, сфокусированное на Office 365 деплойментах, показывает, что 70% бизнесов репортят еженедельные проблемы задержки, и 69% все еще опытят bandwidth проблемы даже после сетевых апгрейдов. Обещание SaaS не автоматически убирает производительностное давление.
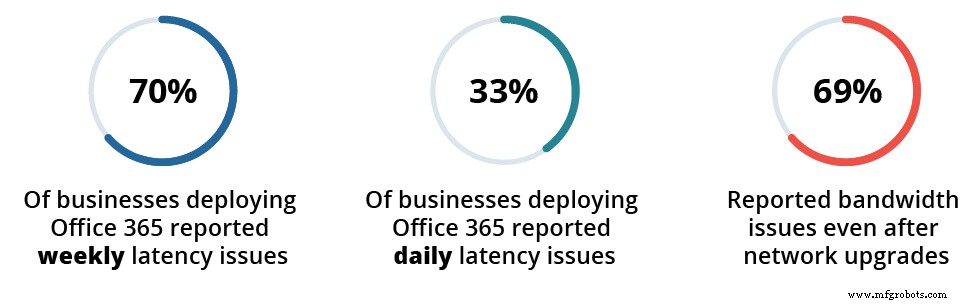 Source: Talkin' Cloud
Что стоит 10% замедление в критическом приложении? Если каждый сотрудник тратит 10% больше времени на завершение задач, это транслируется в 10% производительностный дроп. С 8-часовым рабочим днем и $25 часовой зарплатой, ежедневная стоимость каждого сотрудника $200. 10% деградация результатирует в $20 потерь на сотрудника в день — эквивалент 48 минут потерянной продуктивности. Через 300 сотрудников, это $6 000 ежедневный удар.
За год, если 10% из 250 рабочих дней опытят такие замедления (около 25 дней), организация сталкивается с $150 000 потерь продуктивности. Даже консервативная оценка в 5 задетых дней все еще несет $30 000 потерь.
Затраты управления IT в темноте
Эти цифры иллюстративны, но реальность в том, что большинство компаний лишены непрерывной видимости в свою приложения и сетевую производительность. Производительностные обсуждения обычно взрываются только во время firefight или аутэйджа, оставляя root-cause анализ как afterthought — если он случается вообще — так что проблемы рецидивируют.
Современные IT-инфраструктуры содержат гораздо больше компонентов, чем когда-либо, и проблемы могут возникать в множественных слоях. Например, знаете ли вы, выполнили ли ваши SaaS-провайдеры или ISPs их контрактные SLA комитменты в прошлом году? Работа с облачными и SaaS партнерами теперь часто вовлекает новый вид finger-pointing: «Это ISP или облачный провайдер?»
Потому что большинство современных приложений сильно зависят от сети, измерение производительности требует видимости через оба приложения и базовую сеть. Вот где вступает AppNeta. Наше решение performance-monitoring уточняет root cause проблем в SaaS и веб-приложениях, а также в публичных и облачных сетях провайдеров.
Облачные вычисления
- Почему молибден доминирует в стеклопроизводстве
- Мастерство мониторинга облачных приложений: инсайты для ИТ-лидеров
- Разбор стоимости сертификации Azure DevOps: что нужно знать
- AWS DevOps Certification: стоимость, преимущества и влияние на карьеру
- 10 ключевых факторов для выбора идеального переключателя для вашего приложения
- Мониторинг Интернета вещей: Обеспечение безопасных, надежных IoT-сетей
- Оптимизация жизненного цикла SIM: цифровая стратегия для CSP
- Безопасность IoT от железа до приложения: пошаговый план по слоям
- Роль 0G-технологии в управлении эпидемиями
- Понимание затрат на ЧПУ-обработку: ключевые факторы и оптимизация